¿Por qué los números exactos están matando tus proyectos? El poder de la lógica difusa en la construcción

En el sector de la construcción, cada proyecto es, por definición, un prototipo único que se ejecuta bajo restricciones de tiempo, coste y alcance. Sin embargo, seguimos atrapados en la tiranía de la precisión determinista, intentando predecir resultados con una exactitud quirúrgica que la realidad, siempre cambiante, termina por desmentir. El método del Valor Ganado (EVM) es, sin duda, nuestra mejor herramienta de control, pero su dependencia de números «fríos» pasa por alto la vaguedad inherente a los datos de entrada.

Gestionar un entorno complejo basándose en la ilusión de la precisión no solo constituye un error técnico, sino también un riesgo estratégico. La aplicación de la lógica difusa no debe entenderse como un mero ejercicio matemático, sino como un enfoque más honesto y robusto para gestionar el caos y la imprecisión que definen nuestra industria.
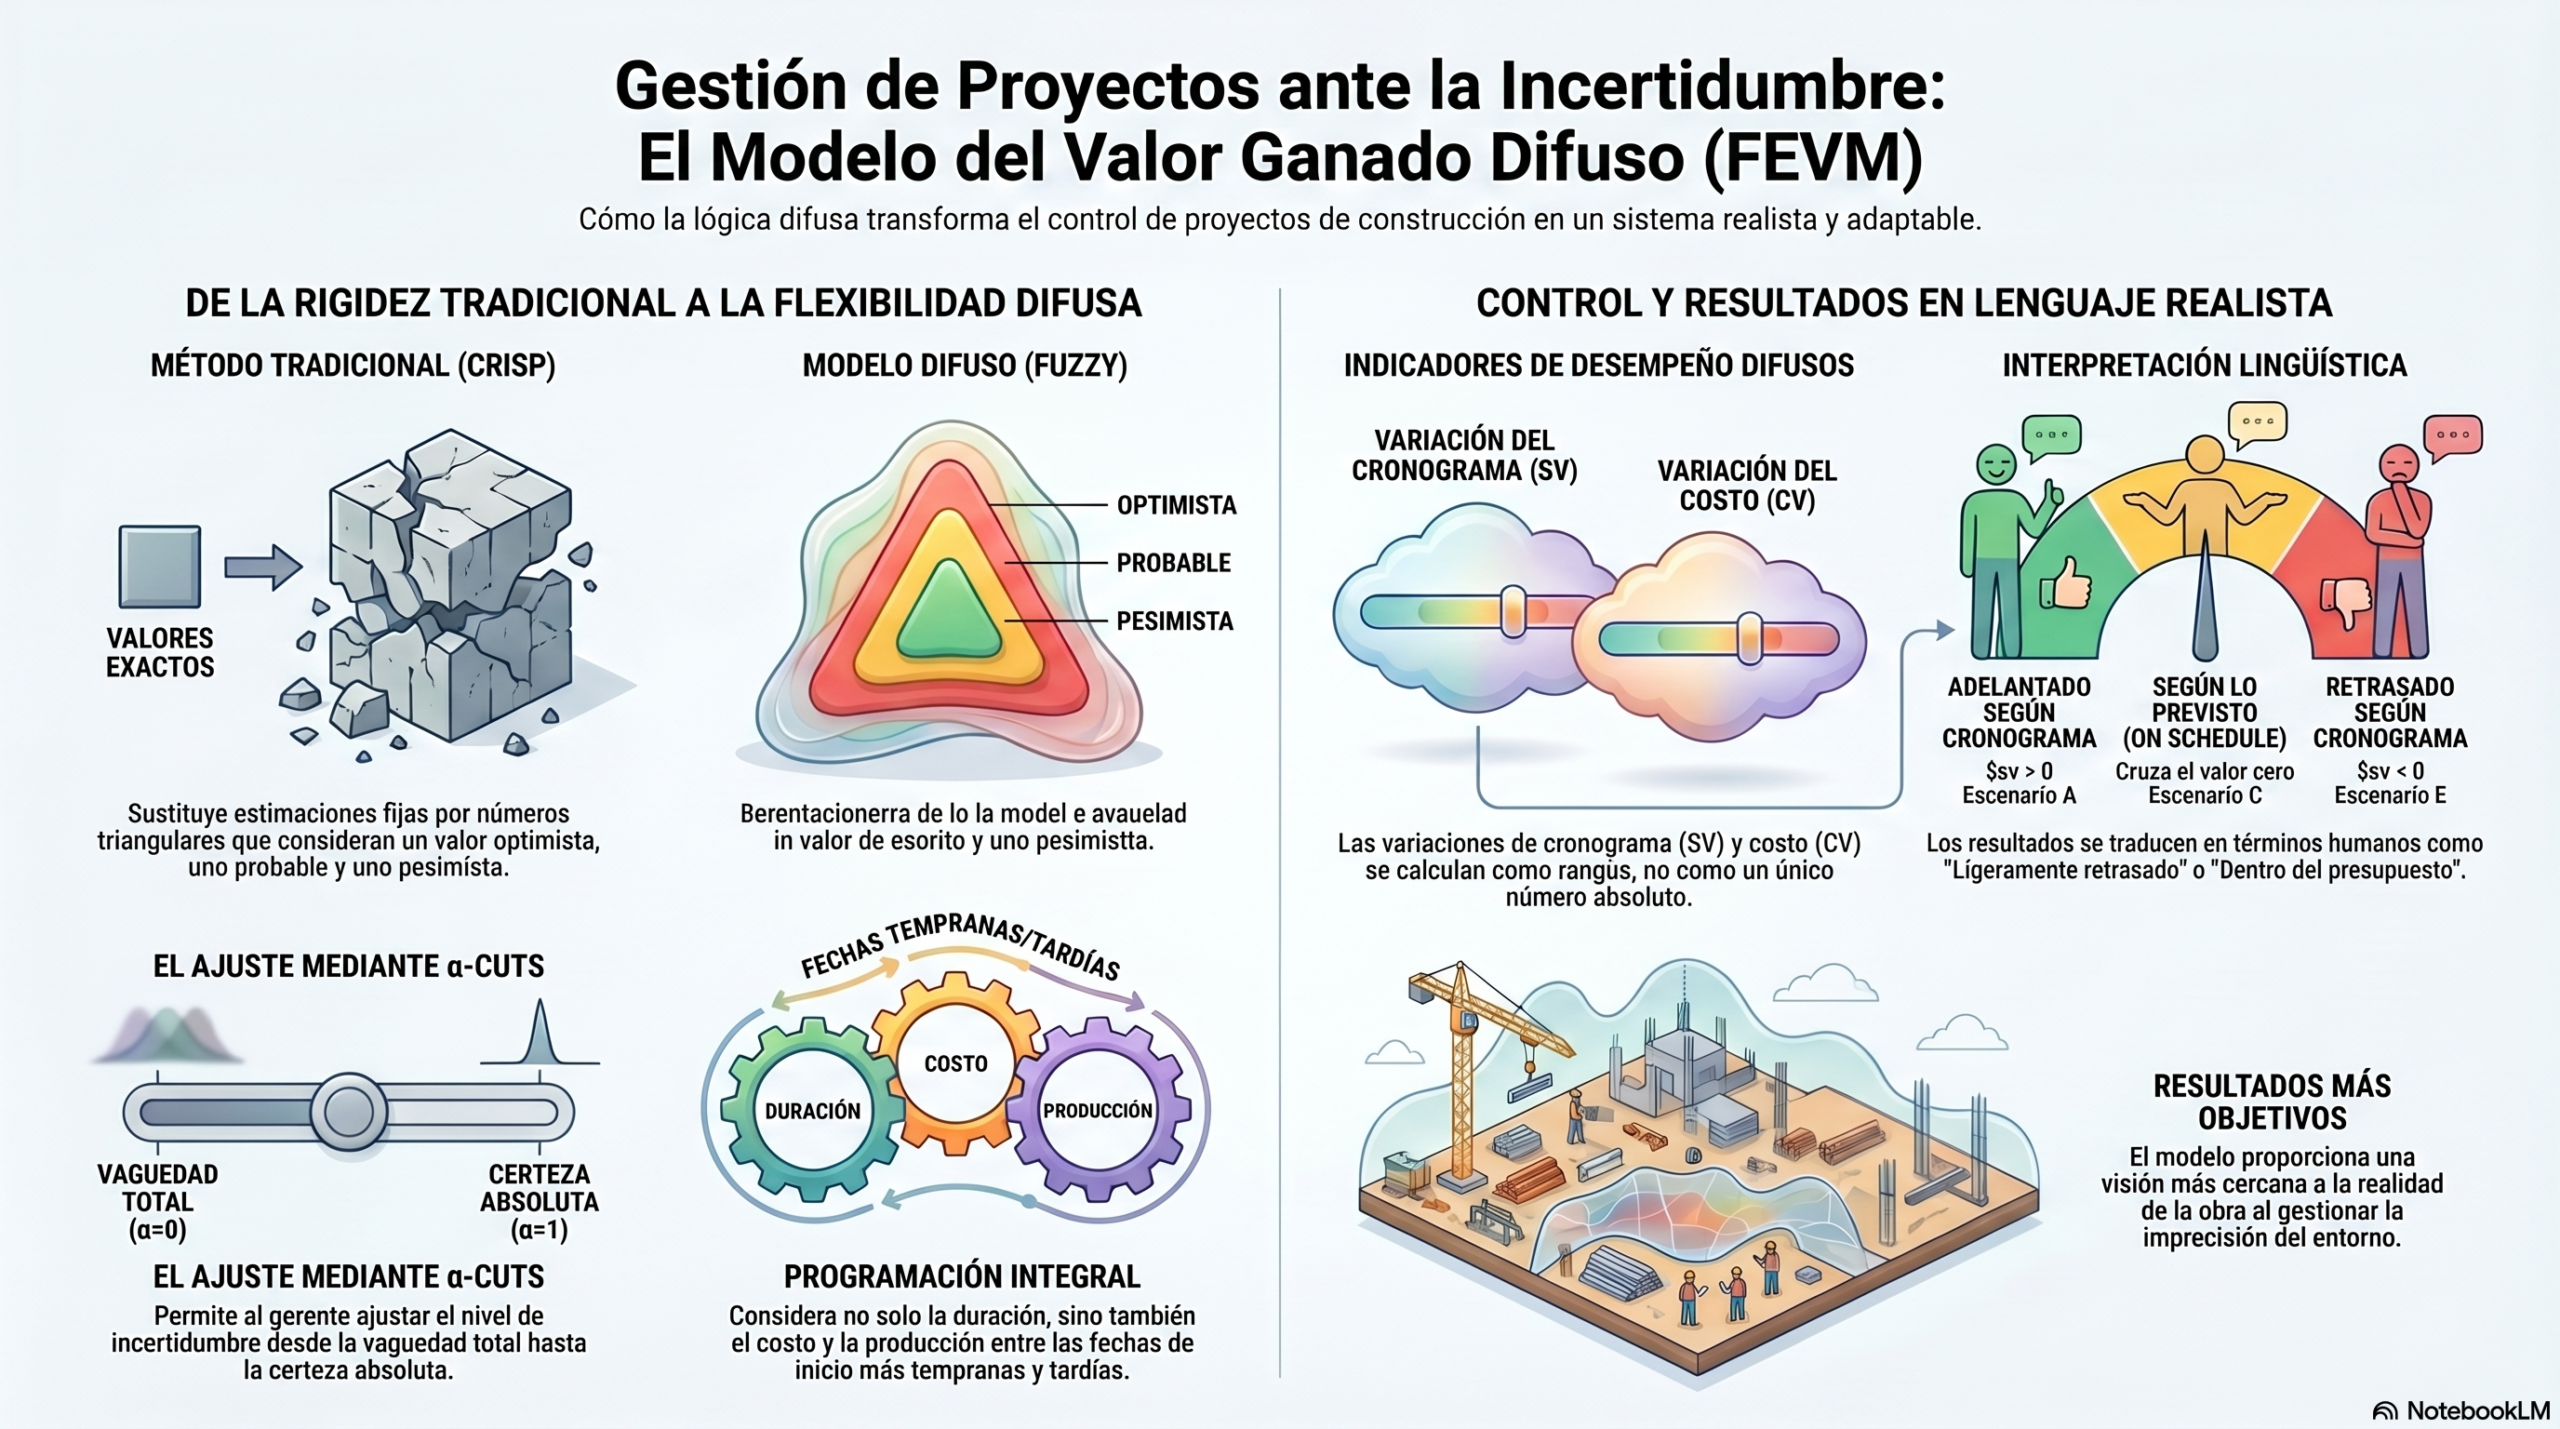
No es azar, es imprecisión: la distinción vital.

Debemos evitar el sesgo de precisión, que confunde dos conceptos fundamentales: la incertidumbre y la imprecisión. El modelo propuesto por Ponz-Tienda et al. (2012) establece una distinción clara que es vital para la toma de decisiones:

  • Incertidumbre: de naturaleza aleatoria, estadística o probabilística.
  • Imprecisión: se refiere a una naturaleza vagamente definida o incompleta (por ejemplo, estimaciones de duración como «alrededor de 10 días»).

Mientras que la estadística tradicional intenta domar el azar, la teoría de los conjuntos difusos es la arquitectura diseñada para manejar lo impreciso. Esta metodología permite realizar operaciones aritméticas con valores que, aunque no se conocen con exactitud, pueden limitarse a fronteras de pertenencia.

Zadeh argumenta que «la probabilidad y la lógica difusa son complementarias, no competitivas. Ambas pueden y deben coexistir para proporcionar herramientas de análisis de la incertidumbre en modelos complejos del mundo real y para cubrir los vacíos que los métodos tradicionales no pueden llenar».
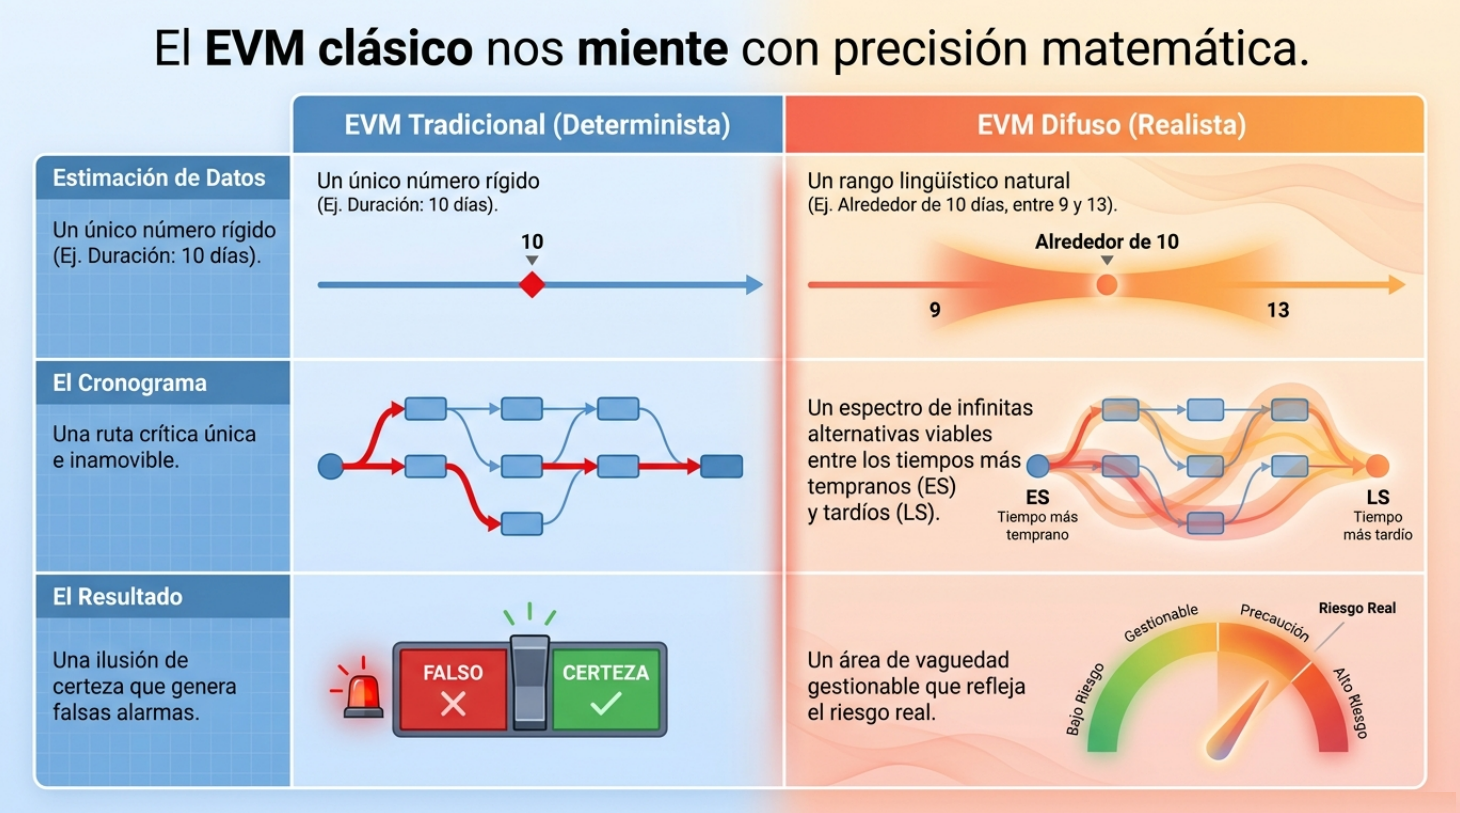
El «dial» de la confianza: ajustando el corte alfa (α-cut).

Una de las innovaciones más importantes del modelo difuso es el corte alfa (α-cut). Este parámetro actúa como un «dial» de control que permite al gestor ajustar la sensibilidad del modelo según su propia confianza o tolerancia al riesgo.

  • Un α-cut igual a 0 representa el soporte del número difuso; es el escenario de máxima vaguedad e incertidumbre, en el que los límites son más amplios.
  • Un α-cut de 1 representa el núcleo (kernel), elimina toda la ambigüedad y equivale al método determinista tradicional.

Esta capacidad de ajuste permite adaptar el modelo a las circunstancias específicas del proyecto. En las primeras fases o en entornos volátiles, un α-cut bajo permite visualizar todo el espectro de riesgos, mientras que en entornos estables, el gestor puede «cerrar» el dial hacia la precisión del núcleo.
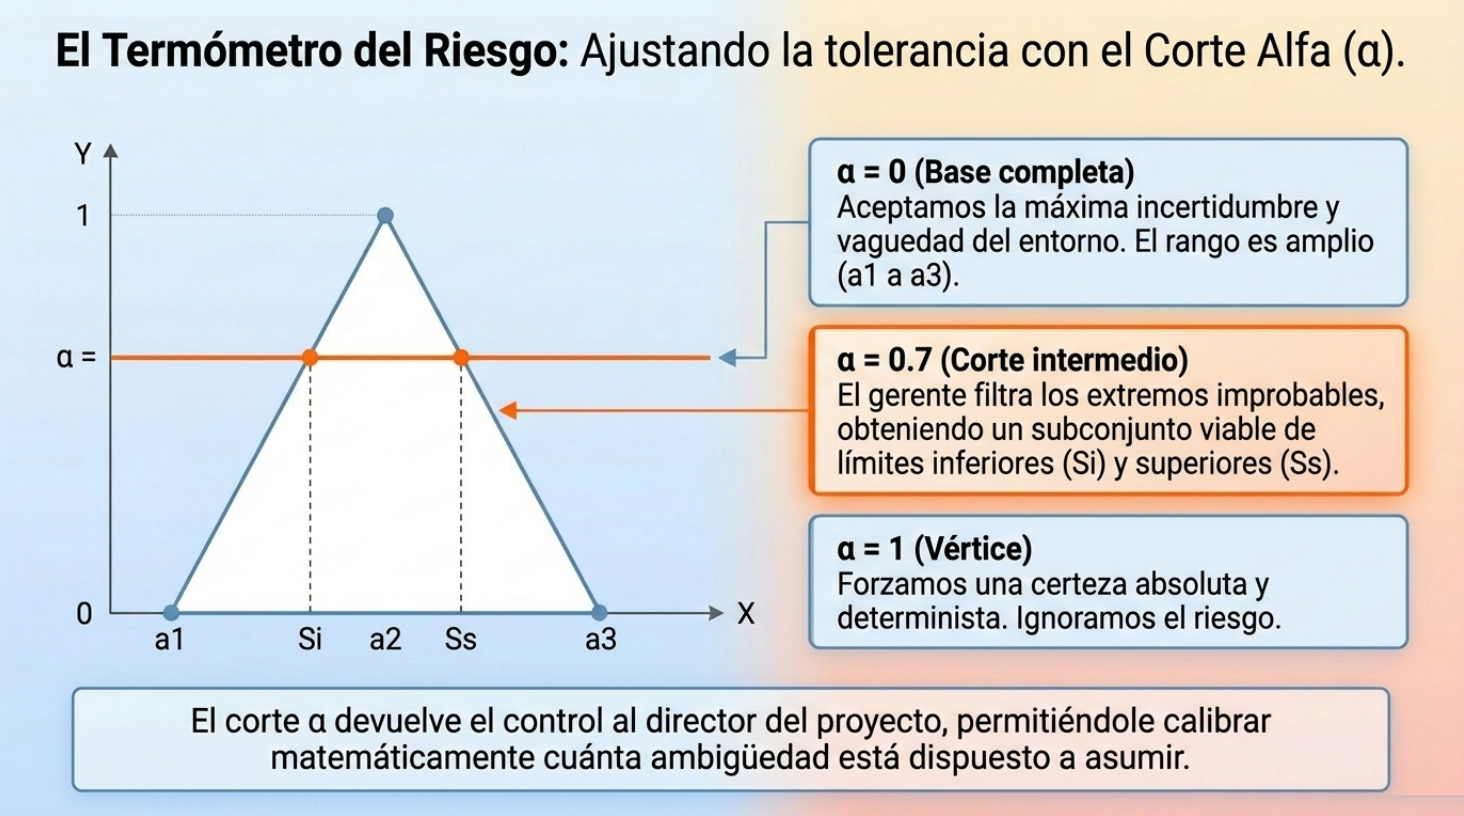
El mito del cronograma único: la realidad del diagrama de Gantt difuso.

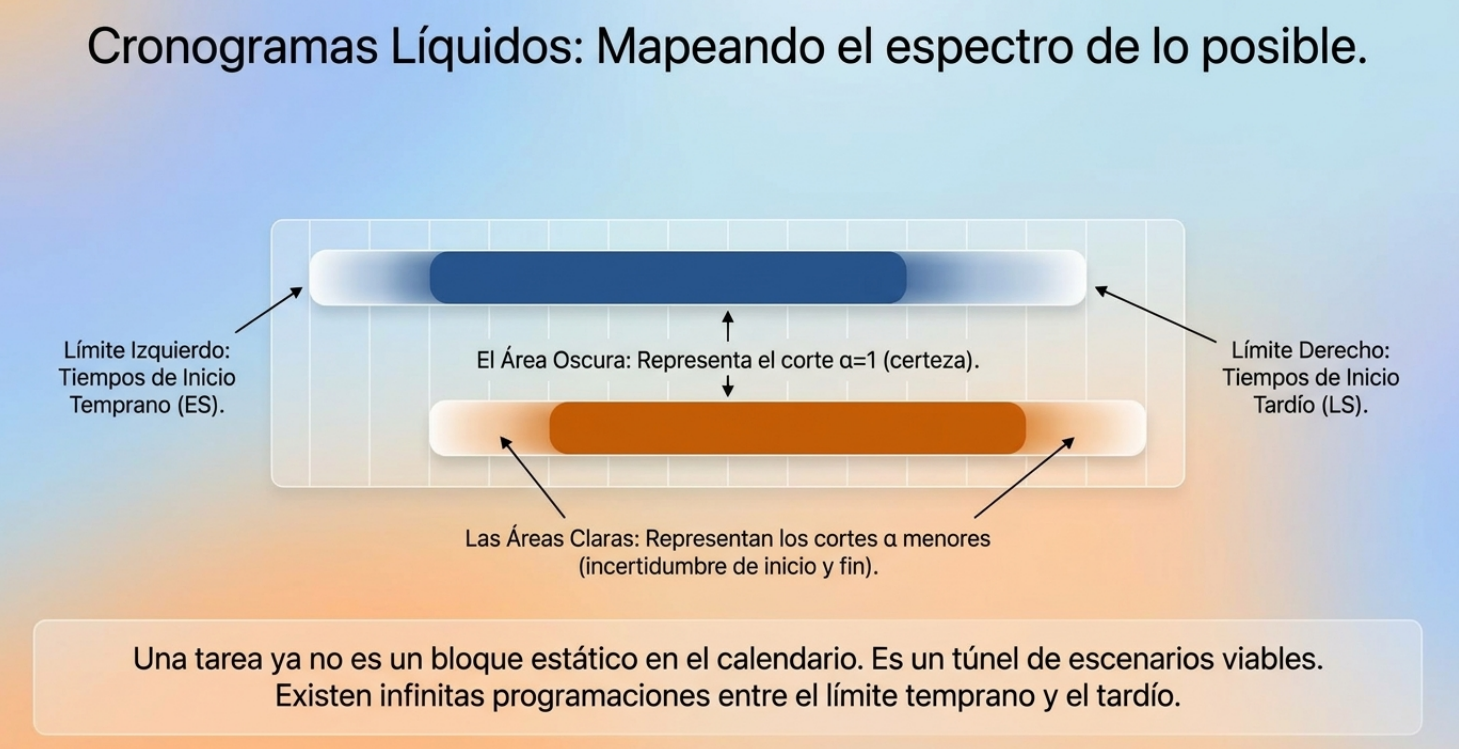
La metodología tradicional suele presentarnos un único cronograma factible como si fuera «la verdad absoluta». No obstante, las conclusiones basadas en un único escenario son inherentemente poco fiables. En la práctica, existe un número ilimitado de alternativas entre los tiempos de ejecución más tempranos y los más tardíos.

El modelo difuso rompe este mito al generar un diagrama de Gantt difuso. Este gráfico no traza una línea, sino que establece los límites superior e inferior de todos los cronogramas posibles. Al utilizar aritmética difusa en lugar de cálculos lineales, el resultado es significativamente más objetivo y proporciona una banda de cumplimiento que refleja la flexibilidad real —y los cuellos de botella potenciales— de la obra.
De métricas abstractas a la salud del proyecto: interpretación lingüística.

El EVM tradicional nos proporciona índices que a menudo no reflejan fielmente el desarrollo real del proyecto. El modelo de Ponz-Tienda innova al traducir variaciones numéricas complejas en categorías lingüísticas claras para los interesados. Esta interpretación se divide en tres dimensiones críticas:

  • Variación de cronograma (SV): evalúa la conformidad del progreso real con el cronograma programado en términos de producción.
  • Variación de coste (CV): mide la conformidad presupuestaria del trabajo efectivamente ejecutado.
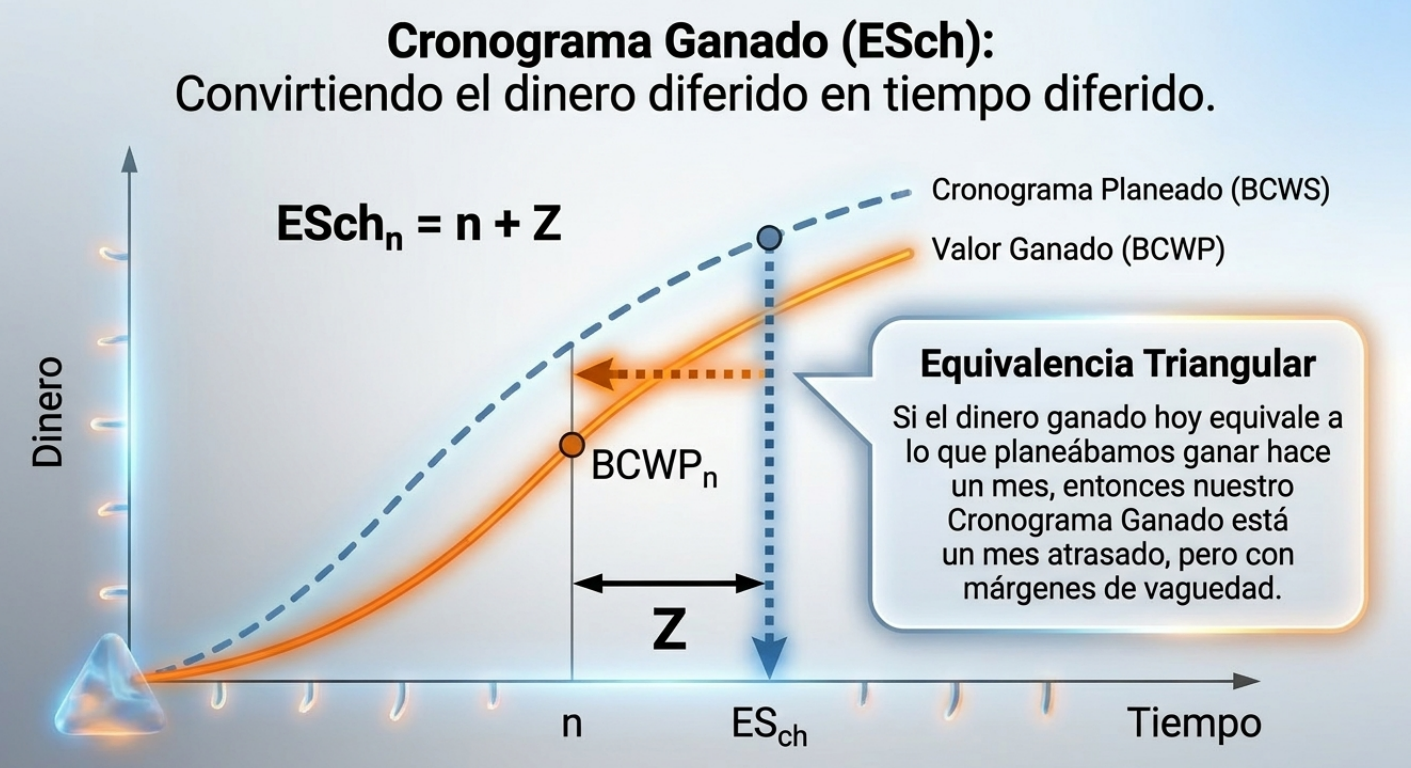
  • Earned Schedule (ESch): traduce el rendimiento en unidades de tiempo reales, evitando los errores del SV tradicional cuando el proyecto excede la fecha de finalización prevista.

Según este modelo, cada dimensión se clasifica en cinco escenarios (del A al E) según el valor de α. Así, un proyecto puede clasificarse estratégicamente como «ligeramente retrasado en tiempo (ESch)», pero «bajo presupuesto (CV)», lo que permite una comunicación mucho más efectiva y humana que un simple decimal.
Innovación integral: el valor ganado difuso.

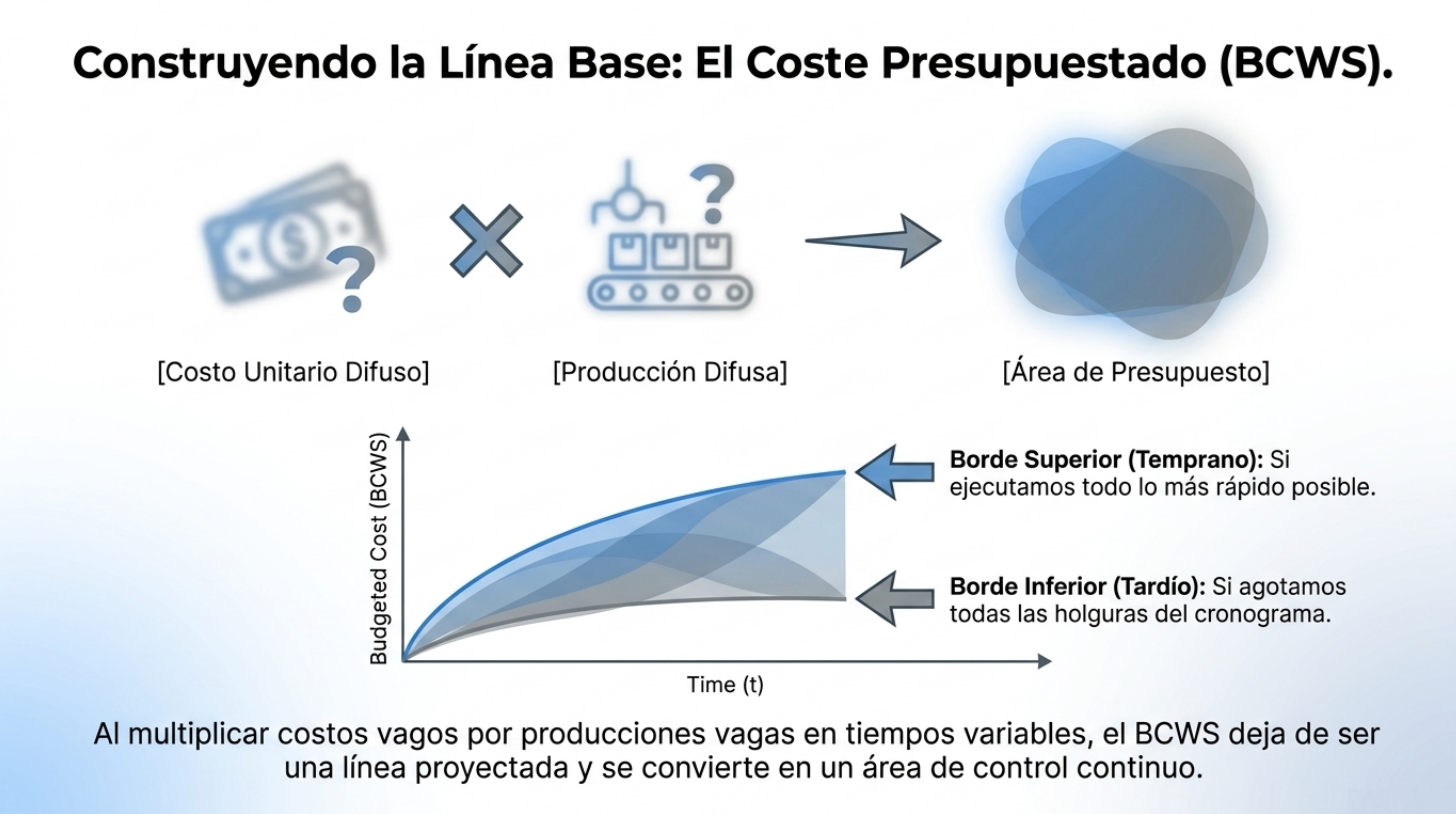
La propuesta de Ponz-Tienda et al. (2012) va más allá de la literatura existente al integrar no solo la duración de las tareas, sino también el coste y la producción en una formulación difusa no lineal. Esto se aplica directamente al BCWS (coste presupuestado del trabajo programado) y al BCWP (valor ganado) y permite capturar la complejidad de las relaciones entre estas variables de una forma que el EVM clásico no puede procesar.

A pesar de su profundidad académica, este modelo no es una utopía inalcanzable. Se ha demostrado su viabilidad técnica para su implementación en herramientas cotidianas, como Microsoft Excel. Esto es esencial, ya que permite superar la barrera académica y llevar la metodología a la práctica empresarial, sirviendo de puente para el desarrollo de software comercial especializado para directores de proyectos.
Conclusión: hacia una gestión de proyectos más humana y robusta.

El enfoque del Valor Ganado Difuso nos ofrece una «visión de conjunto» que acepta la imprecisión del mundo real en lugar de ignorarla. Al adoptar este modelo, pasamos de gestionar basándonos en puntos ficticios a tomar decisiones basadas en rangos realistas y sólidos.

Es importante entender que esta contribución no es una herramienta «llave en mano», sino un punto de partida para especialistas. El futuro de la gestión de riesgos en la construcción depende de nuestra capacidad para refinar estos modelos y establecer el valor de α-cut más cercano a la realidad de cada obra.

Como líderes, la pregunta final es inevitable: ¿Seguiremos gestionando nuestros proyectos bajo la falsa comodidad de un número exacto o daremos el paso hacia la honestidad estratégica de un rango difuso que realmente refleje la realidad?

En esta conversación puedes escuchar las ideas más interesantes sobre este tema.

Este vídeo resume bien los conceptos explicados.

Fuzzy_Earned_Value_Management

Referencia:

PONZ-TIENDA, J.L.; PELLICER, E.; YEPES, V. (2012). Complete fuzzy scheduling and fuzzy earned value management in construction projects. Journal of Zhejiang University-SCIENCE A (Applied Physics & Engineering), 13(1):56-68. DOI:10.1631/jzus.A1100160

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.
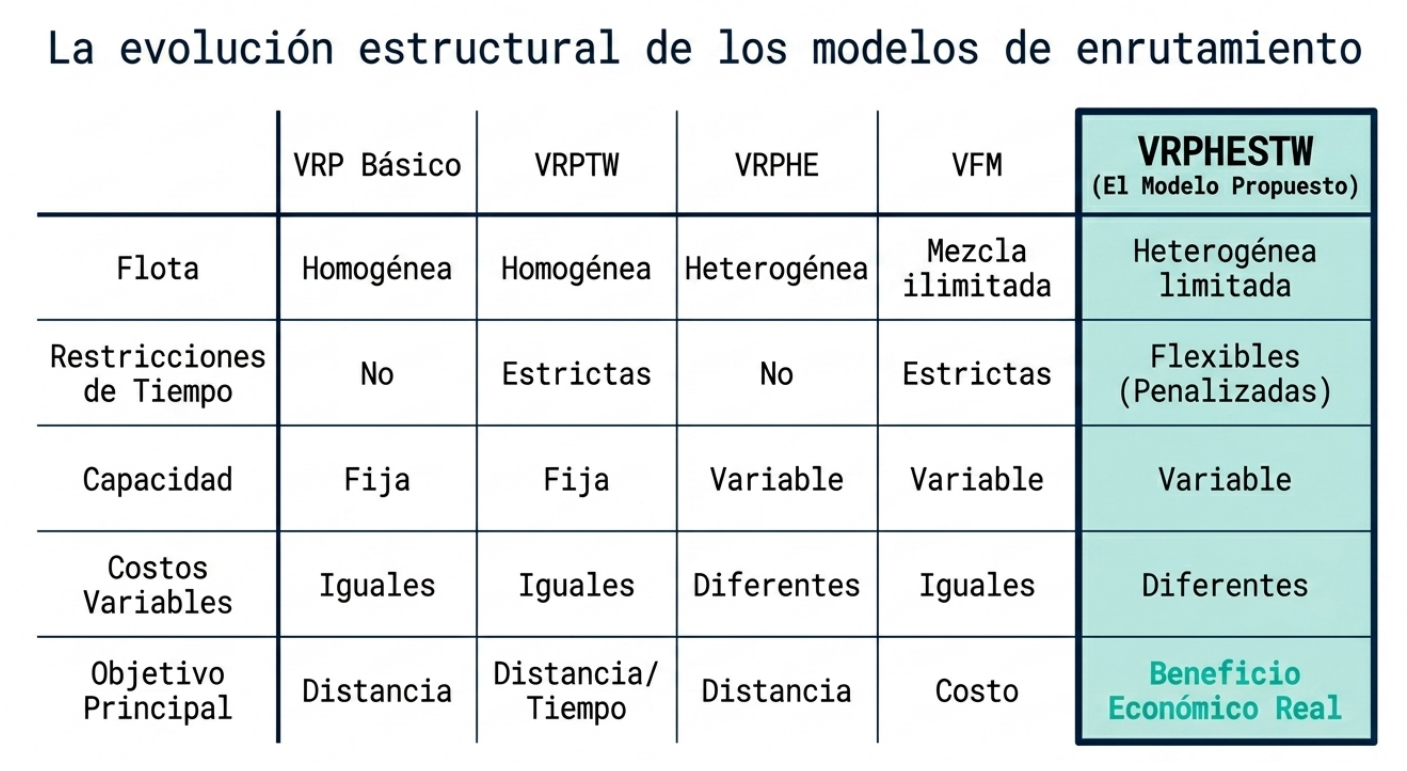
Logística en tiempos de cambio: Cómo la optimización heurística se adapta a los vaivenes de la economía real

Más allá del GPS: por qué la ruta más corta no siempre es la más rentable.

Para cualquier responsable de operaciones, la intuición dicta una regla aparentemente infalible: cuanto menos kilómetros se recorren, mayores son los márgenes. Sin embargo, ante la complejidad de la última milla contemporánea, esta lógica resulta peligrosamente incompleta. El ahorro en combustible suele verse compensado por penalizaciones por entregas tardías, ineficiencias en el uso de la capacidad de carga o por el coste oculto de ignorar las regulaciones laborales.

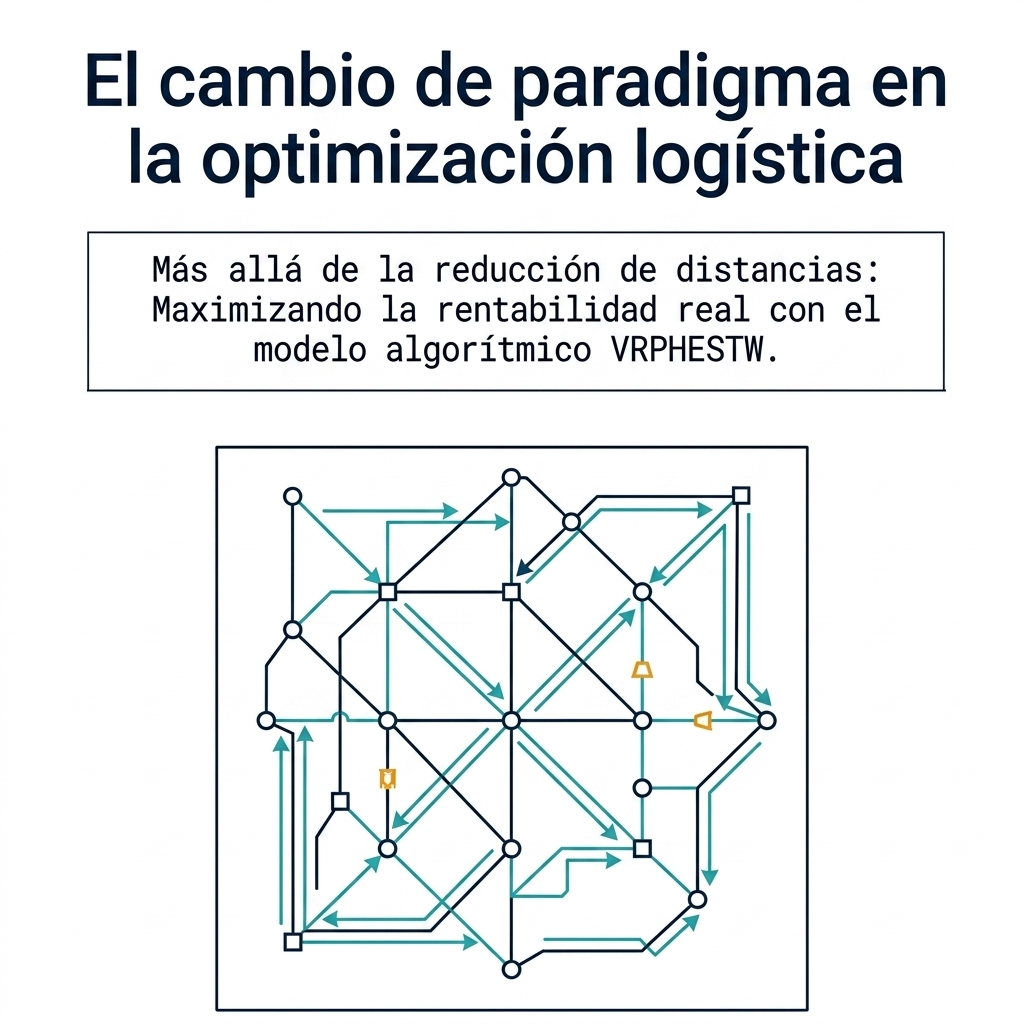
El éxito no consiste en reducir la distancia de forma simplista, sino en maximizar la rentabilidad operativa. Es aquí donde el problema de las rutas de vehículos con flotas heterogéneas y ventanas de tiempo flexibles (VRPHESTW, Vehicle Routing Problem with Heterogeneous Fleet and Soft Time Windows) surge como la respuesta científica al caos logístico. Este modelo trasciende el mapa al integrar variables económicas, humanas y temporales en una única ecuación estratégica. Este artículo se basa en uno de los resultados más importantes de mi tesis doctoral, publicada en un trabajo que podéis encontrar al final de las referencias (Yepes y Medina, 2006).

La rentabilidad total sobre la distancia total recorrida: la nueva métrica de éxito.

El enfoque tradicional se limita a minimizar el consumo de kilómetros. No obstante, la logística de alto nivel exige una función con un objetivo económico que considere la operación como un centro de beneficios y no solo de costes. La fórmula es clara:

Beneficio = Ingresos Totales – Costes Operativos – Costes de Penalización por Ventanas de Tiempo.

En este modelo, los ingresos no son una cifra estática, sino que se consideran dos tasas: una fija por servicio y otra variable en función de la distancia y del volumen de la mercancía. La gran innovación es que la satisfacción del cliente se convierte en un activo negociable. Al monetizar los retrasos mediante penalizaciones, el algoritmo decide de forma autónoma si resulta más rentable aceptar una pequeña desviación en el horario de entrega o invertir en un vehículo adicional. La logística moderna, por tanto, no busca el «cumplimiento a cualquier precio», sino el equilibrio óptimo entre el servicio y el margen.

El poder estratégico de una flota «mixta».

Una de las mayores ventajas competitivas del transporte radica en la heterogeneidad. El modelo demuestra que una flota uniforme tiende a ser ineficiente. El algoritmo realiza un arbitraje constante entre distintos tipos de vehículos para encontrar la combinación que minimiza el coste total de propiedad y operación.

En este análisis, la selección de vehículos (categorizados como k = 1, 2 o 3) no solo se basa en el volumen de carga, sino también en un equilibrio sofisticado entre:

  • Capacidad y velocidad: desde el vehículo pequeño y ágil (k = 1), ideal para zonas urbanas densas, hasta el «pesado» (k = 3), con gran capacidad, pero mayor coste fijo y menor velocidad de maniobra.
  • Estructura de costes laborales: el sistema evalúa el impacto financiero de pasar de la remuneración por hora legal a las horas extraordinarias y, finalmente, a las severas penalizaciones económicas derivadas del exceso de jornada laboral, protegiendo así la rentabilidad y la seguridad jurídica de la empresa.

Como señala el estudio:

«Los problemas de rutas de vehículos en el mundo real requieren una función objetivo económica para medir la calidad de las soluciones».

Ventanas de tiempo flexibles: el tiempo como variable económica elástica.

En la logística convencional, una ventana de tiempo es un muro infranqueable: llegar un minuto tarde se considera un fallo del sistema. El concepto de «soft time windows» (ventanas de tiempo flexibles) revoluciona esta noción al considerar el tiempo como una variable económica elástica.

En lugar de prohibir las entregas fuera de horario, el modelo establece una penalización económica escalonada en función de la antelación o el retraso. Esta flexibilidad calculada permite que el sistema de optimización identifique rutas que, aunque «incumplen» ligeramente el horario, logran una consolidación de carga tan eficiente que el beneficio neto final es muy superior al de una ruta de cumplimiento rígido. Se pasa así de una logística de obediencia a una logística de resultados.

El hallazgo sorprendente: el valor estratégico del sesgo.

El descubrimiento más disruptivo de la investigación consiste en distinguir entre la función «objetivo» (el beneficio real que queremos obtener) y la función «guía» (las instrucciones que le damos al algoritmo para explorar el mapa).

En un experimento revelador, los investigadores «engañaron» al algoritmo aumentando artificialmente en un 10 % los costes de distancia en la función guía (escenario HES-B). Al evaluar la ruta resultante con los costes reales (escenario HES-A), el beneficio neto aumentó un 6,4 %.

¿Por qué funciona este sesgo estratégico? Al sobreponderar el coste de la distancia durante la fase de búsqueda, se obliga al algoritmo a encontrar clústeres de clientes extremadamente compactos y rutas más robustas que el peso económico estándar pasaría por alto. Este fenómeno demuestra que, para escapar de los «óptimos locales» (soluciones que parecen buenas, pero no lo son), a veces es necesario alterar la topología del problema para forzar al sistema a encontrar la excelencia global.

Un marco de tres pilares para la implementación.

Para ejecutar esta estrategia, se propone un marco de optimización híbrido que integra la exploración creativa y el rigor matemático.

  1. Fase de construcción inteligente (GRASP): no se generan rutas al azar, sino que se inicia el proceso seleccionando clientes «semilla» según criterios de alta rentabilidad y dificultad logística, lo que asegura un punto de partida sólido.
  2. Fase de diversificación global (VNS): el sistema utiliza una «búsqueda de vecindario variable» para desafiar las rutas establecidas. En esta fase se introduce variedad para evitar que la operación se estanque en las soluciones obvias.
  3. Fase de intensificación de precisión (algoritmo de umbral): un pulido final que somete cada ruta a un escrutinio de costes extremo, aceptando incluso soluciones ligeramente peores temporalmente para alcanzar el máximo céntimo de beneficio potencial.

Conclusión: hacia una logística con visión de negocio.

La optimización de rutas ha dejado de ser un problema geográfico para convertirse en una disciplina puramente estratégica de economía. El uso de algoritmos avanzados que integran flotas heterogéneas y ventanas de tiempo flexibles permite a las empresas navegar por la volatilidad de los costes y las exigencias del mercado con una precisión quirúrgica.

Optimizar no consiste solo en llegar antes, sino en comprender el coste exacto de cada minuto y cada kilómetro para decidir, basándose en datos, qué configuración de flota garantiza el crecimiento sostenible del negocio.

Pregunta para reflexionar: En su operación actual, ¿está optimizando para que sus vehículos recorran menos distancia o para que su balance de situación sea más robusto?

Puedes escuchar en esta conversación algunas de las ideas más interesantes sobre este tema.

Este vídeo resume bien los conceptos básicos tratados.

Maximizing_Logistics_Profitability

Referencia:

YEPES, V.; MEDINA, J.R. (2006). Economic Heuristic Optimization for Heterogeneous Fleet VRPHESTW. Journal of Transportation Engineering, 132(4): 303-311. DOI: 10.1061/(ASCE)0733-947X(2006)132:4(303)

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.
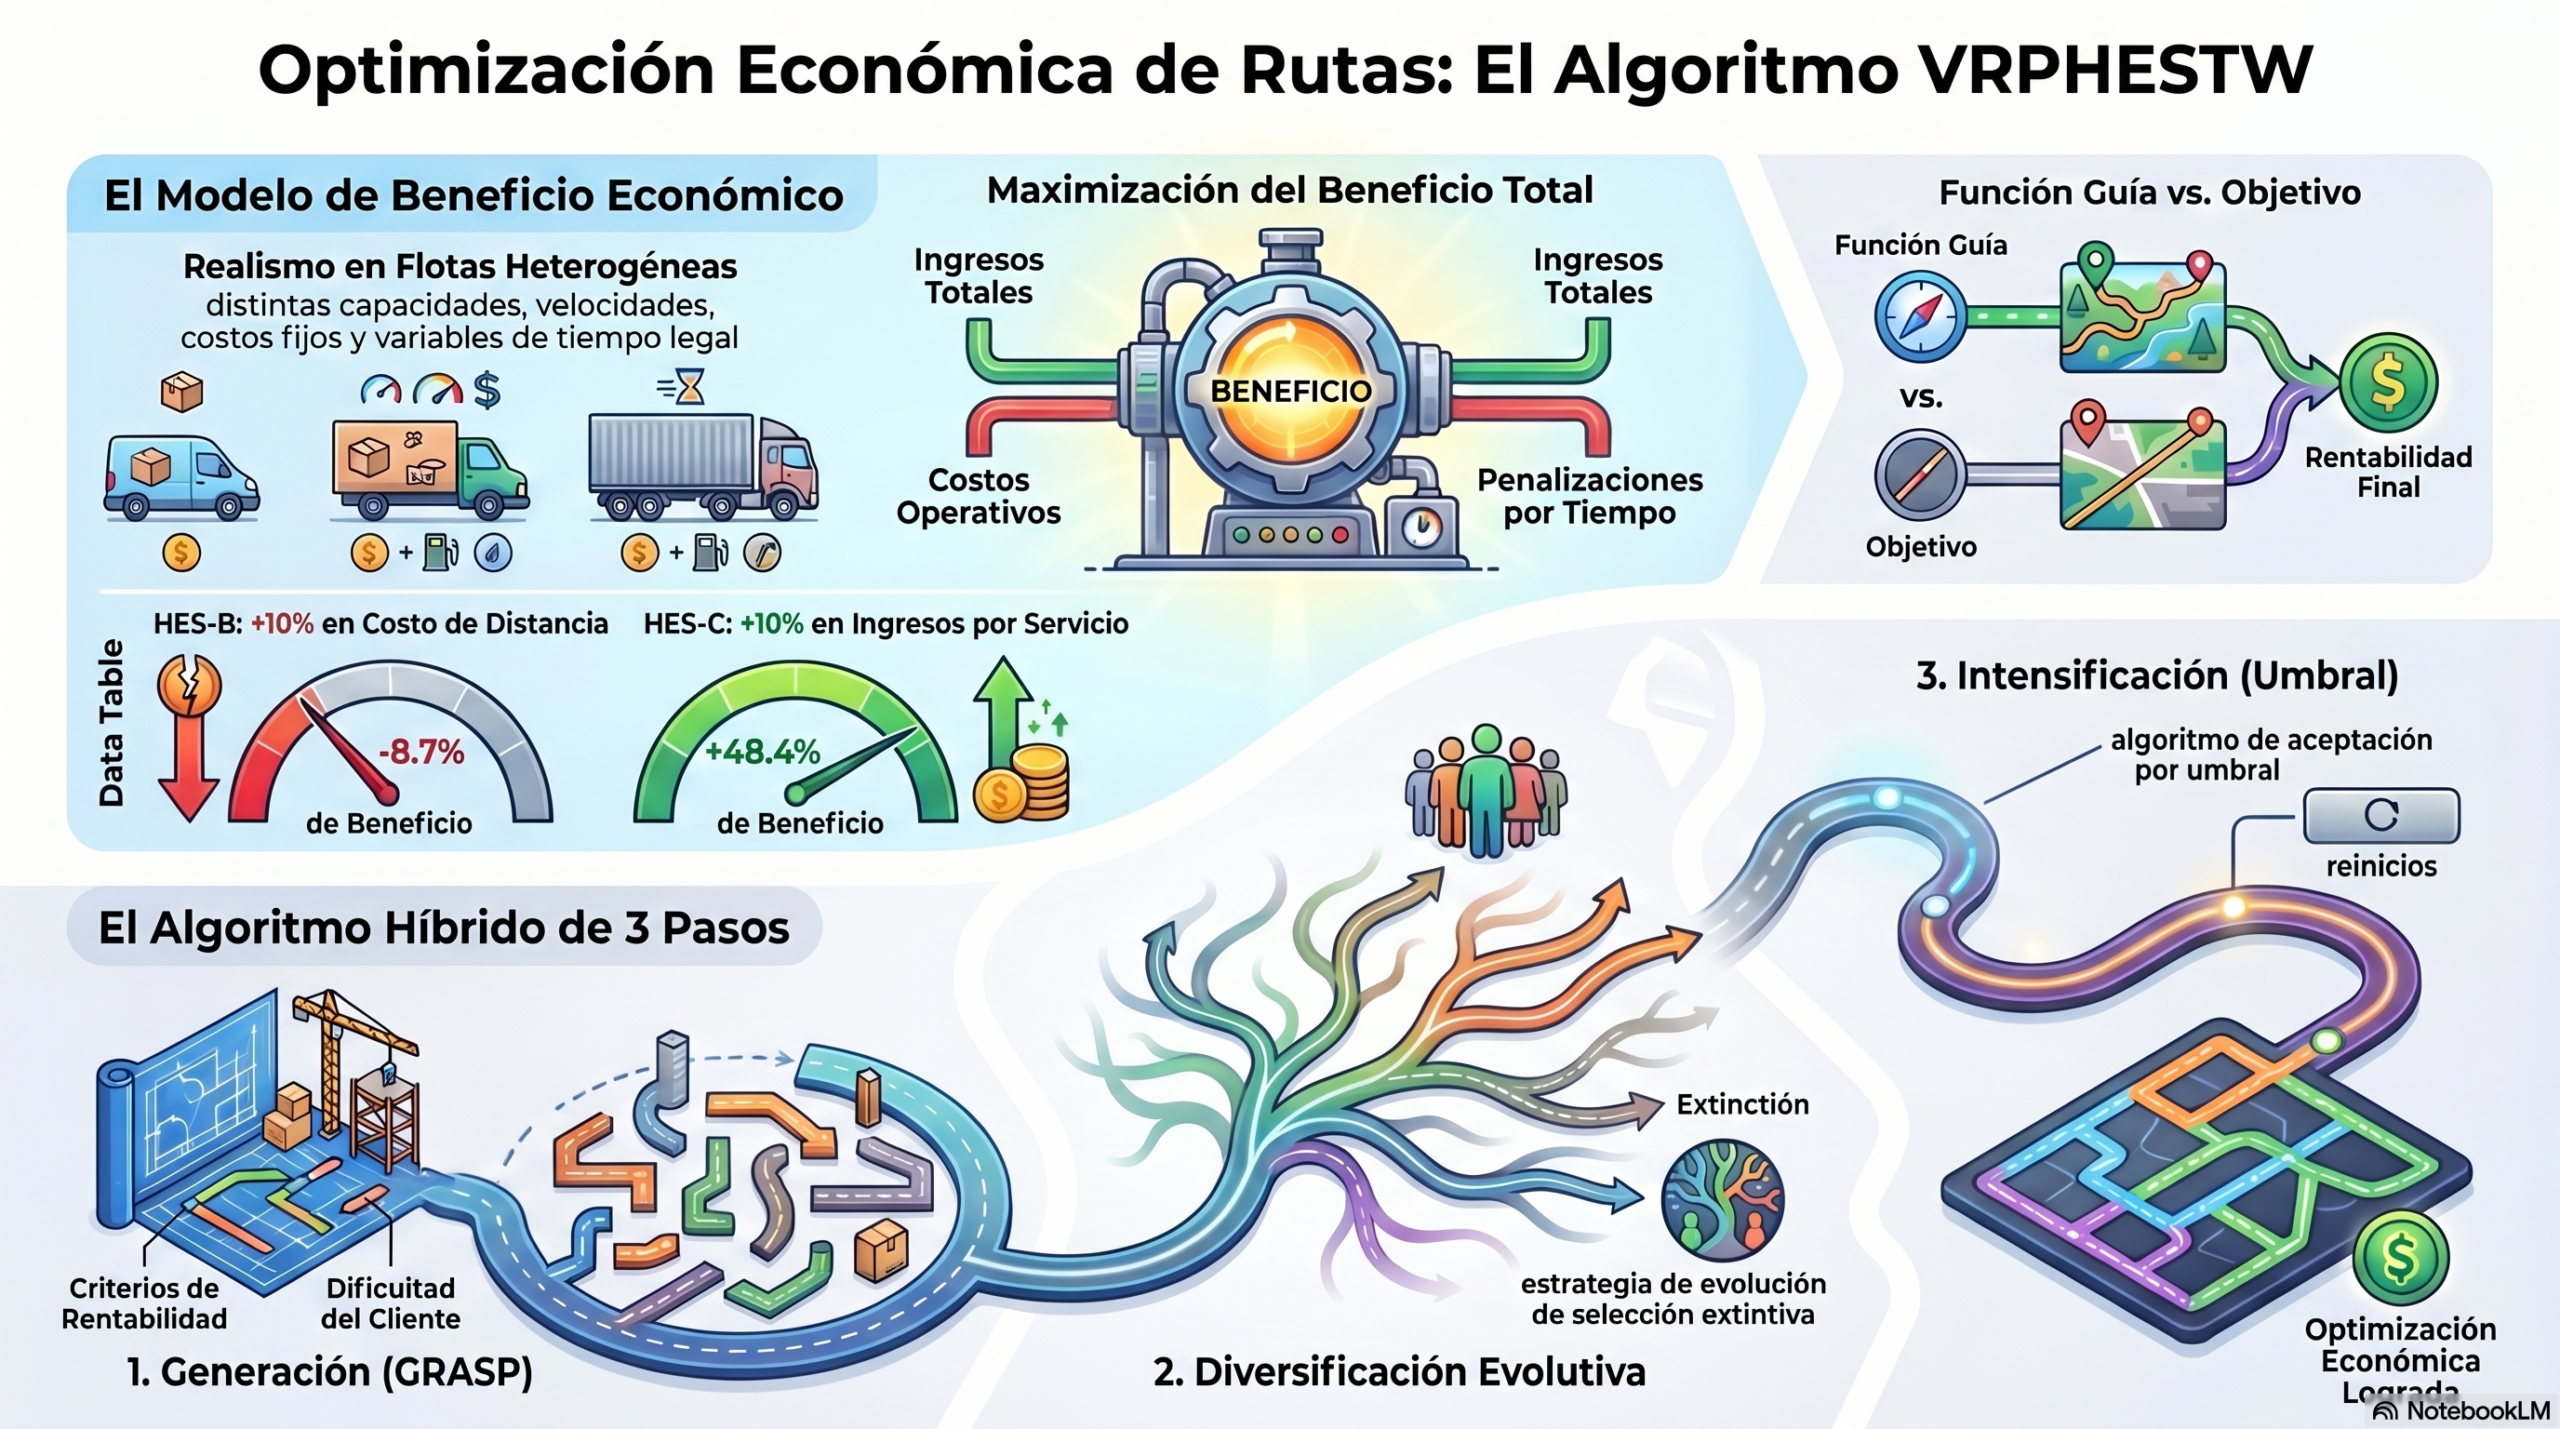
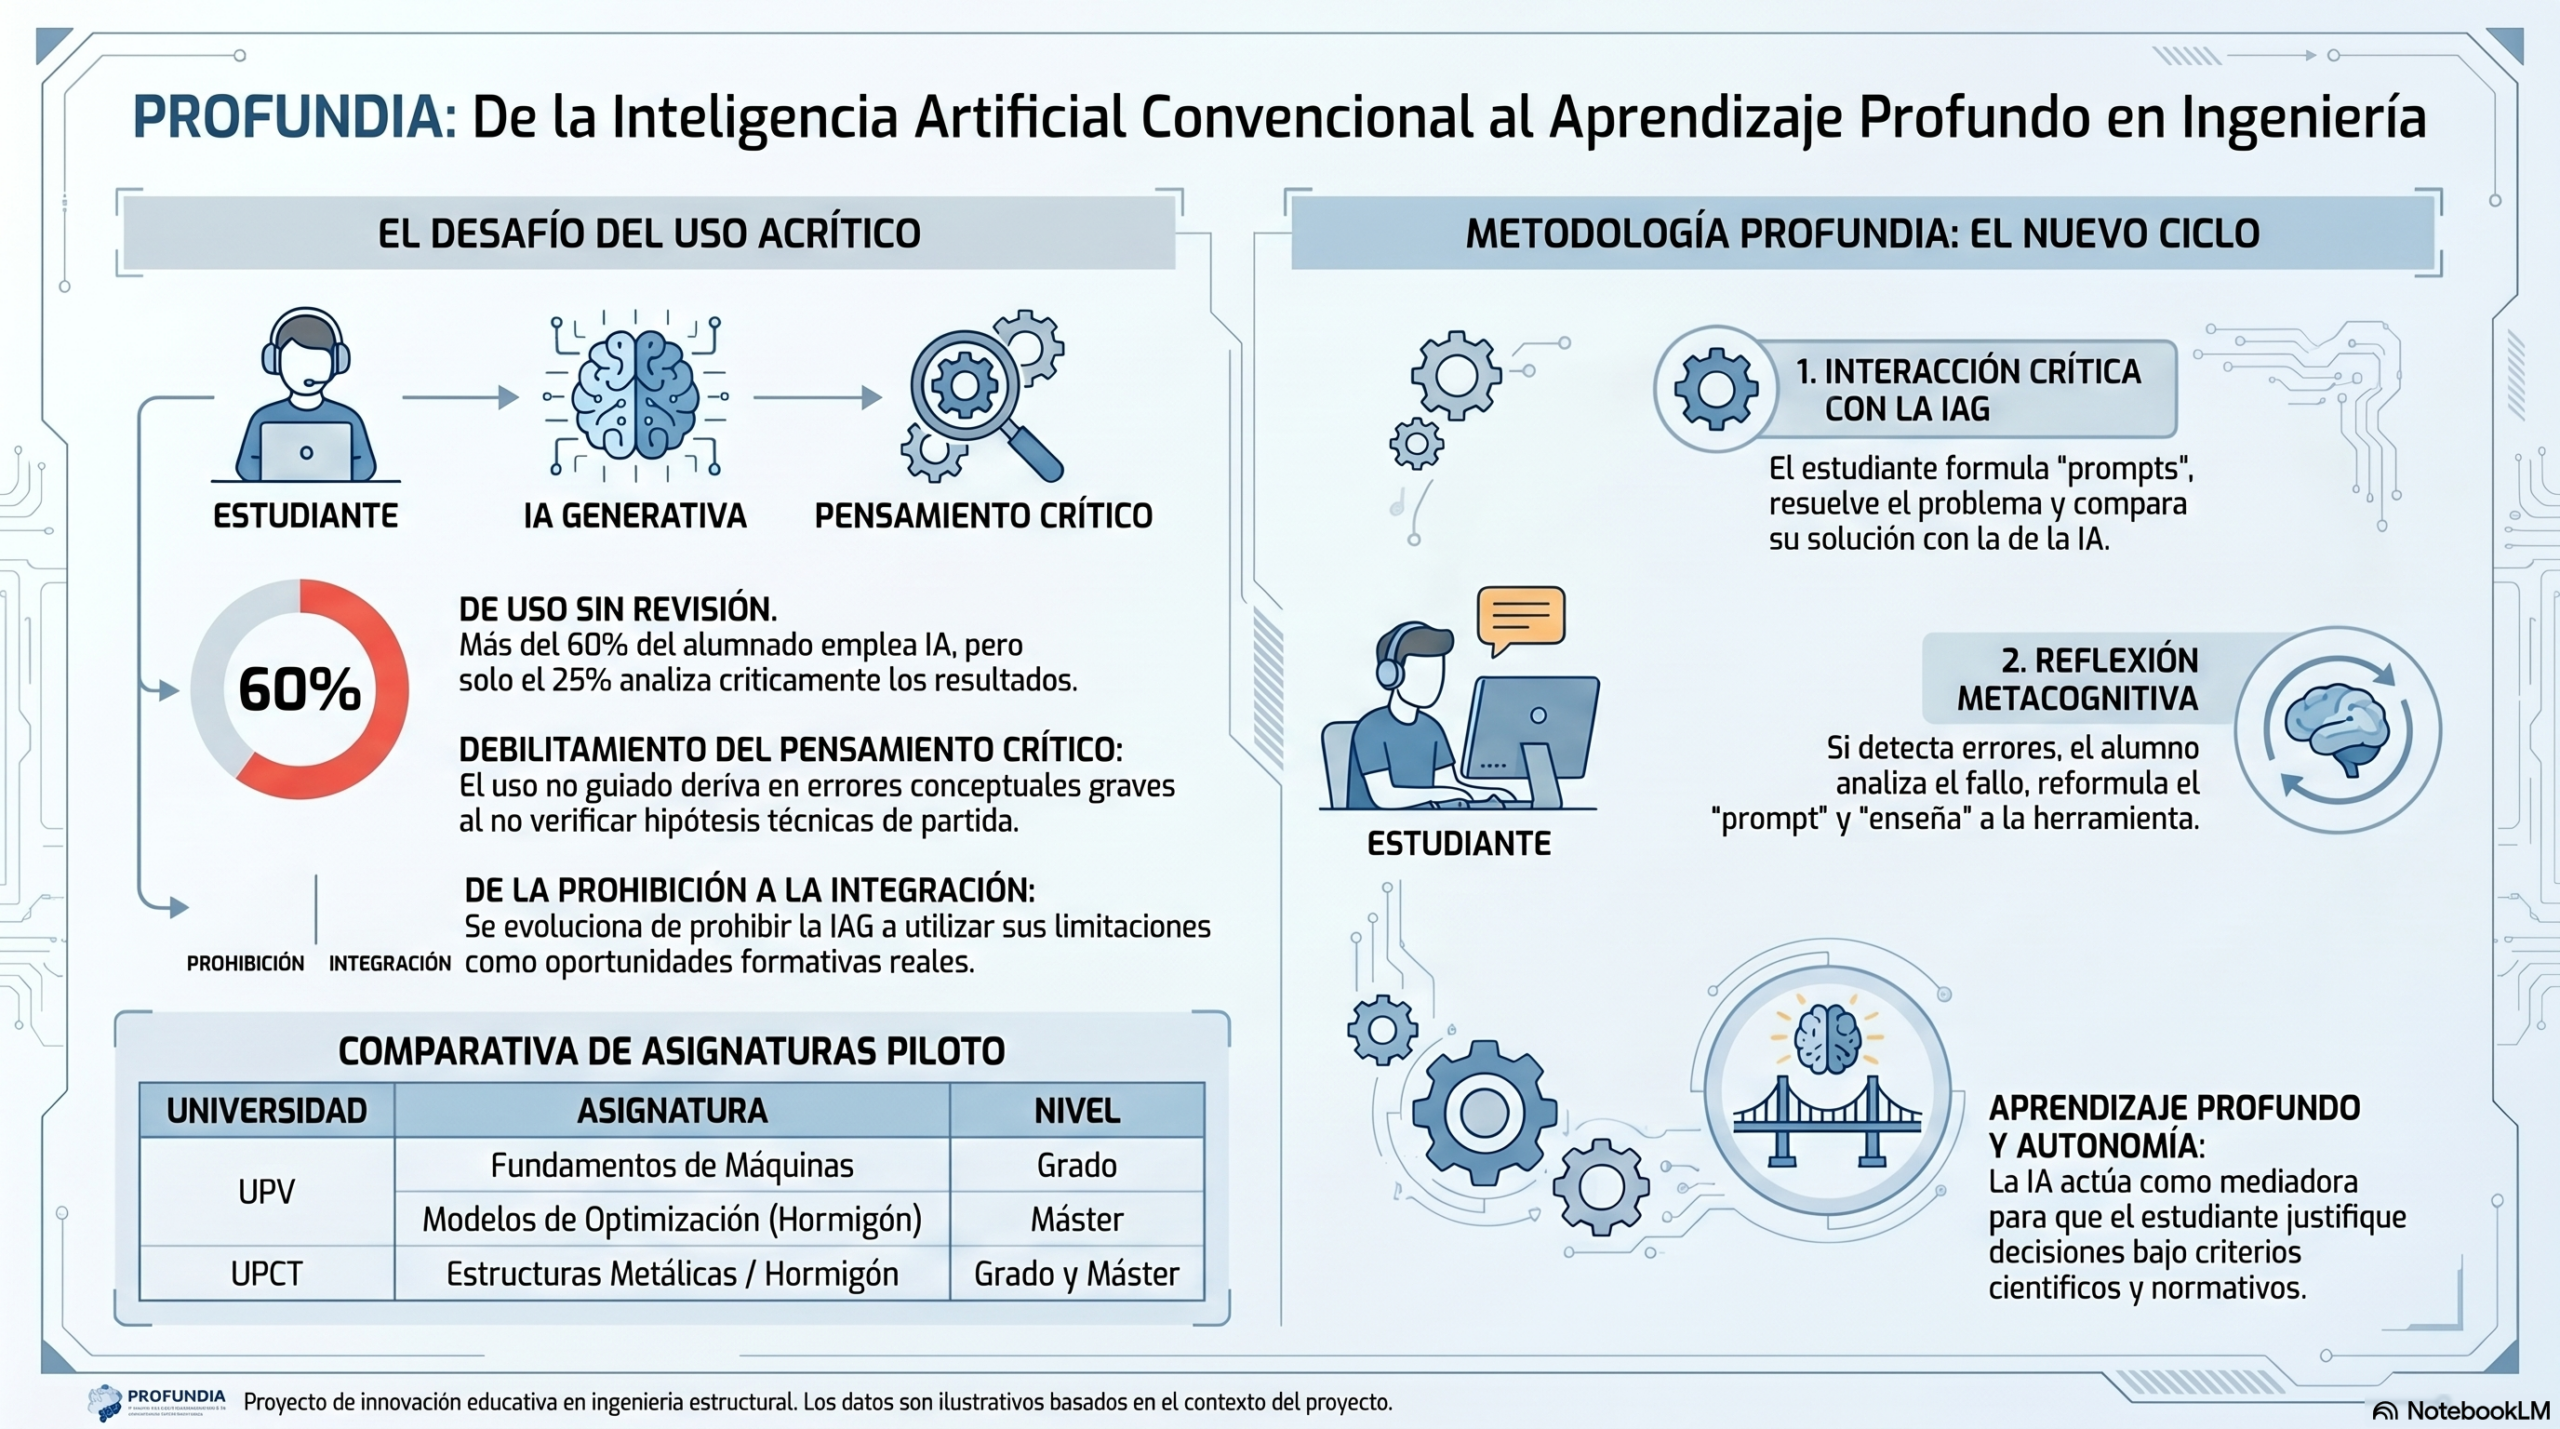
De la prohibición al aprendizaje profundo: cómo la IA está transformando la formación de los futuros ingenieros.

Introducción: El dilema del aula moderna.

En ingeniería civil, un error de cálculo no es solo una errata en un examen, sino una cuestión de seguridad pública y de responsabilidad ética. Por ello, el panorama actual resulta alarmante: mientras que más del 60 % de los estudiantes reconoce utilizar inteligencia artificial generativa (IAG) en sus tareas, apenas un 25 % realiza una revisión crítica de los resultados.

Esta dependencia acrítica amenaza con diluir el rigor técnico necesario para diseñar infraestructuras seguras. Ante este desafío nace el proyecto PROFUNDIA, liderado por el catedrático Víctor Yepes en la Universitat Politècnica de València (UPV), en colaboración con la Universidad Politécnica de Cartagena (UPCT). Nuestra misión es clara: transformar la IA de un «atajo peligroso» en un motor de aprendizaje profundo que refuerce la autonomía del futuro ingeniero.

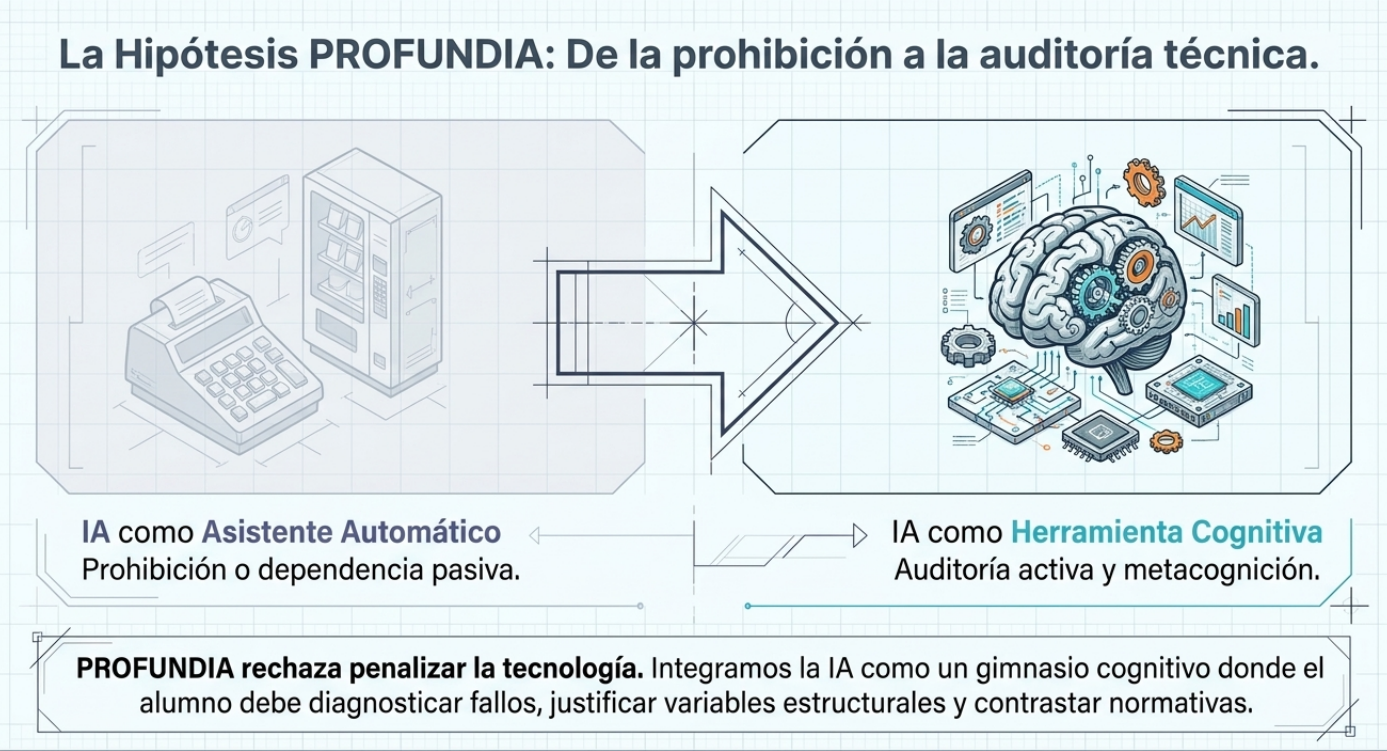
El fin de la era de la prohibición: de «No usar» a «Usar para pensar».

Durante los últimos años, la respuesta académica dominante ha sido la restricción. Sin embargo, en un entorno profesional de alta exigencia, prohibir la tecnología es una batalla perdida que solo agrava la brecha entre el aula y la realidad. PROFUNDIA propone un cambio de paradigma radical: integrar la IA como una «herramienta cognitiva» o «mindtool», bajo la filosofía constructivista de Jonassen.

No buscamos que el estudiante aprenda «de» la tecnología como si esta fuera un oráculo, sino «con» la tecnología. Al utilizar la IA como mediadora, el alumno no se limita a recibir datos, sino que debe «luchar» con la herramienta para construir un modelo mental sólido de los fenómenos físicos. En ingeniería, el objetivo no es obtener el número final, sino comprender el comportamiento estructural que ese número representa.

«Enseñar» a la IA para aprender ingeniería.

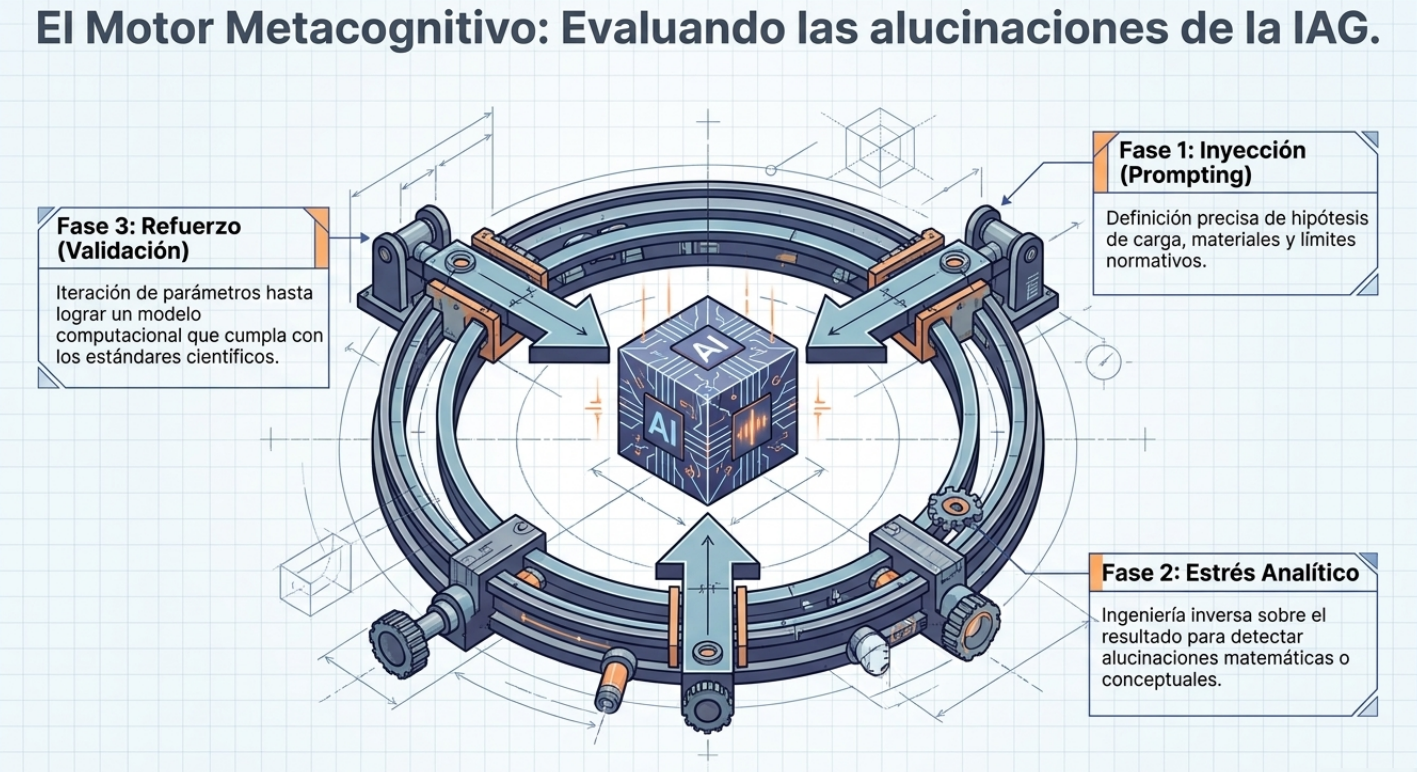
El corazón de nuestra metodología se basa en un concepto disruptivo: el «sesgo deliberado hacia el error». En asignaturas críticas como «Modelos predictivos de estructuras de hormigón» o «Resistencia de materiales», hemos observado que la IA tiende a «alucinar» al proponer hipótesis de partida o al aplicar normativas específicas. En lugar de considerar esto como una limitación, lo convertimos en nuestra principal ventaja pedagógica.

Obligamos al estudiante a enfrentarse a las respuestas de la IA no como verdades absolutas, sino como borradores que deben ser auditados. Para corregir los cálculos de la máquina en una viga o en un pórtico, el alumno primero debe dominar la teoría de forma exhaustiva.

«En PROFUNDIA, el estudiante invierte los roles tradicionales: deja de ser un receptor pasivo para convertirse en el «maestro» de la IA, validando, cuestionando y corrigiendo la tecnología con su propio juicio técnico y rigor científico».

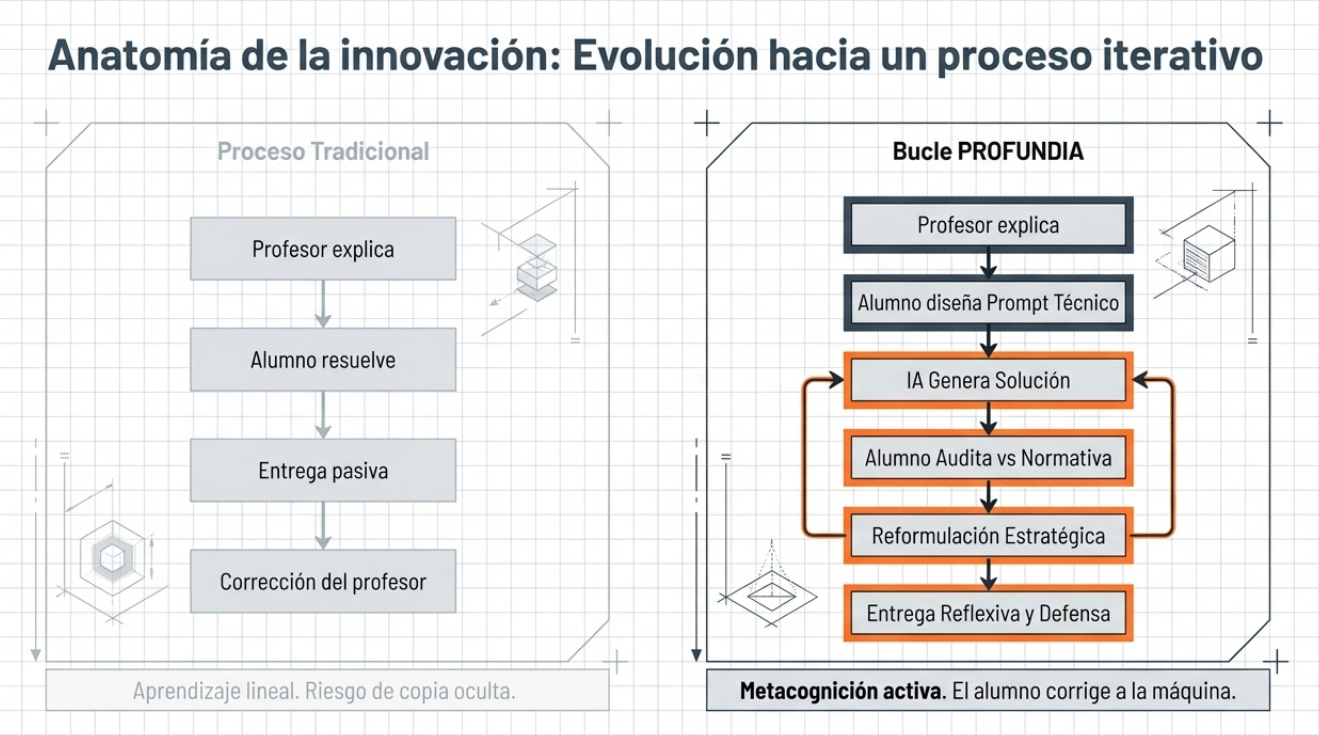
El ciclo del «prompt crítico»: reflexión metacognitiva.

Para estructurar este proceso, hemos diseñado una secuencia metodológica (basada en la Figura 2 del proyecto) que obliga al estudiante a reflexionar metacognitivamente de manera constante.

  • Formulación del prompt: el alumno debe traducir un problema de estructuras metálicas o de hormigón a un lenguaje técnico preciso, definiendo cargas, luces y condiciones de contorno.
  • Comparación crítica: se contrasta el resultado de la IA con modelos analíticos propios y con programas informáticos profesionales de cálculo.
  • Detección de errores y reformulación: aquí es donde ocurre el aprendizaje real. El estudiante debe identificar si el error de la IA se debe a un cálculo matemático incorrecto, a una hipótesis física errónea o a un desconocimiento del Código Estructural. Tras el análisis, debe guiar a la IA, mediante nuevos mensajes, hacia la solución correcta.
  • Justificación técnica: el paso final consiste en validar la solución según los criterios científicos y normativos vigentes, a fin de garantizar que la respuesta no solo «parezca» correcta, sino que también sea técnicamente viable y segura.

Más allá del aula: preparación para el mundo real.

La colaboración entre la UPV y la UPCT (con los profesores Antonio Tomás y Pedro Martínez-Pagán) permite validar este modelo en diversos contextos, desde los grados hasta los másteres. El objetivo no es simplemente aprobar la asignatura de Estructuras Metálicas, sino desarrollar el criterio técnico experto que hoy demandan las empresas de ingeniería.

En el ejercicio profesional, el ingeniero es el último responsable de la empresa que avala un proyecto. PROFUNDIA prepara a los egresados para que puedan actuar como auditores tecnológicos, capaces de aprovechar la eficiencia de la IA sin comprometer nunca la integridad estructural ni la seguridad de las personas.

Un entorno de aprendizaje enriquecido.

La innovación de este proyecto no radica en el software (ChatGPT es solo una herramienta), sino en la redefinición metodológica del entorno de aprendizaje. Hemos transformado el aula en un laboratorio de interacción social y psicológica en el que la IA actúa como un «agente activo» dentro del equipo de trabajo. Esta dinámica fomenta una mayor implicación del alumnado, que percibe el aprendizaje no como una carga, sino como el desarrollo de la maestría en las herramientas que definirán su futuro.

Conclusión: Hacia una ingeniería de pensamiento profundo.

La visión de PROFUNDIA consiste en formar ingenieros que lideren la tecnología en lugar de depender de ella. La eficiencia de un algoritmo es una herramienta poderosa, pero carece de la comprensión profunda y de la responsabilidad ética que definen nuestra profesión.

Al final, cuando nos enfrentamos al diseño de un puente o una infraestructura de gran envergadura, debemos plantearnos una pregunta provocadora: en un futuro en el que las máquinas pueden realizar cálculos en milisegundos, ¿seremos capaces de formar a ingenieros con la suficiente intuición y criterio técnico como para negarnos a firmar un proyecto que la IA considera «eficiente», pero que el juicio humano reconoce como un riesgo de colapso? El futuro de nuestra seguridad depende de esa capacidad crítica.

En esta conversación puedes escuchar las ideas más interesantes de este proyecto.

Este vídeo resume bien el proyecto PROFUNDIA.

PROFUNDIA_Structural_Engineering_AI

Referencias:

Blight, T., Martínez-Pagán, P., Roschier, L., Boulet, D., Yepes-Bellver, L., & Yepes, V. (2025). Innovative approach of nomography application into an engineering educational context. PloS one, 20(2), e0315426.

Castro-Aristizabal, G., Acosta-Ortega, F., & Moreno-Charris, A. V. (2024). Los entornos de aprendizaje y el éxito escolar en Latinoamérica. Lecturas de Economía, (101), 7-46.

Hadgraft, R. G., & Kolmos, A. (2020). Emerging learning environments in engineering education. Australasian Journal of Engineering Education, 25(1), 3-16.

Jiang, N., Zhou, W., Hasanzadeh, S., & Duffy Ph D, V. G. (2025). Application of Generative AI in Civil Engineering Education: A Systematic Review of Current Research and Future Directions. In CIB Conferences (Vol. 1, No. 1, p. 306).

Jonassen, D. H., Peck, K. L., & Wilson, B. G. (1999). Learning with technology: A constructivist perspective. Columbus, OH: Merrill/Prentice-Hall.

Liao, W., Lu, X., Fei, Y., Gu, Y., & Huang, Y. (2024). Generative AI design for building structures. Automation in Construction, 157, 105187.

Navarro, I. J., Marti, J. V., & Yepes, V. (2023). Evaluation of Higher Education Students’ Critical Thinking Skills on Sustainability. International Journal of Engineering Education, 39(3), 592-603.

Onatayo, D., Onososen, A., Oyediran, A. O., Oyediran, H., Arowoiya, V., & Onatayo, E. (2024). Generative AI applications in architecture, engineering, and construction: Trends, implications for practice, education & imperatives for upskilling—a review. Architecture, 4(4), 877-902.

Pellicer, E., Yepes, V., Ortega, A. J., & Carrión, A. (2017). Market demands on construction management: View from graduate students. Journal of Professional Issues in Engineering Education and Practice, 143(4), 04017005.

Perkins, D., & Unger, C. (1999). La enseñanza para la comprensión. Argentina: Paidós.

Torres-Machí, C., Carrión, A., Yepes, V., & Pellicer, E. (2013). Employability of graduate students in construction management. Journal of Professional Issues in Engineering Education and Practice, 139(2), 163-170.

Xu, G., & Guo, T. (2025). Advances in AI-powered civil engineering throughout the entire lifecycle. Advances in Structural Engineering, 13694332241307721.

Zhou, Z., Tian, Q., Alcalá, J., & Yepes, V. (2025). Research on the coupling of talent cultivation and reform practice of higher education in architecture. Computers and Education Open, 100268.

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.
Redes Neuronales Artificiales: El cerebro digital que imita la inteligencia humana

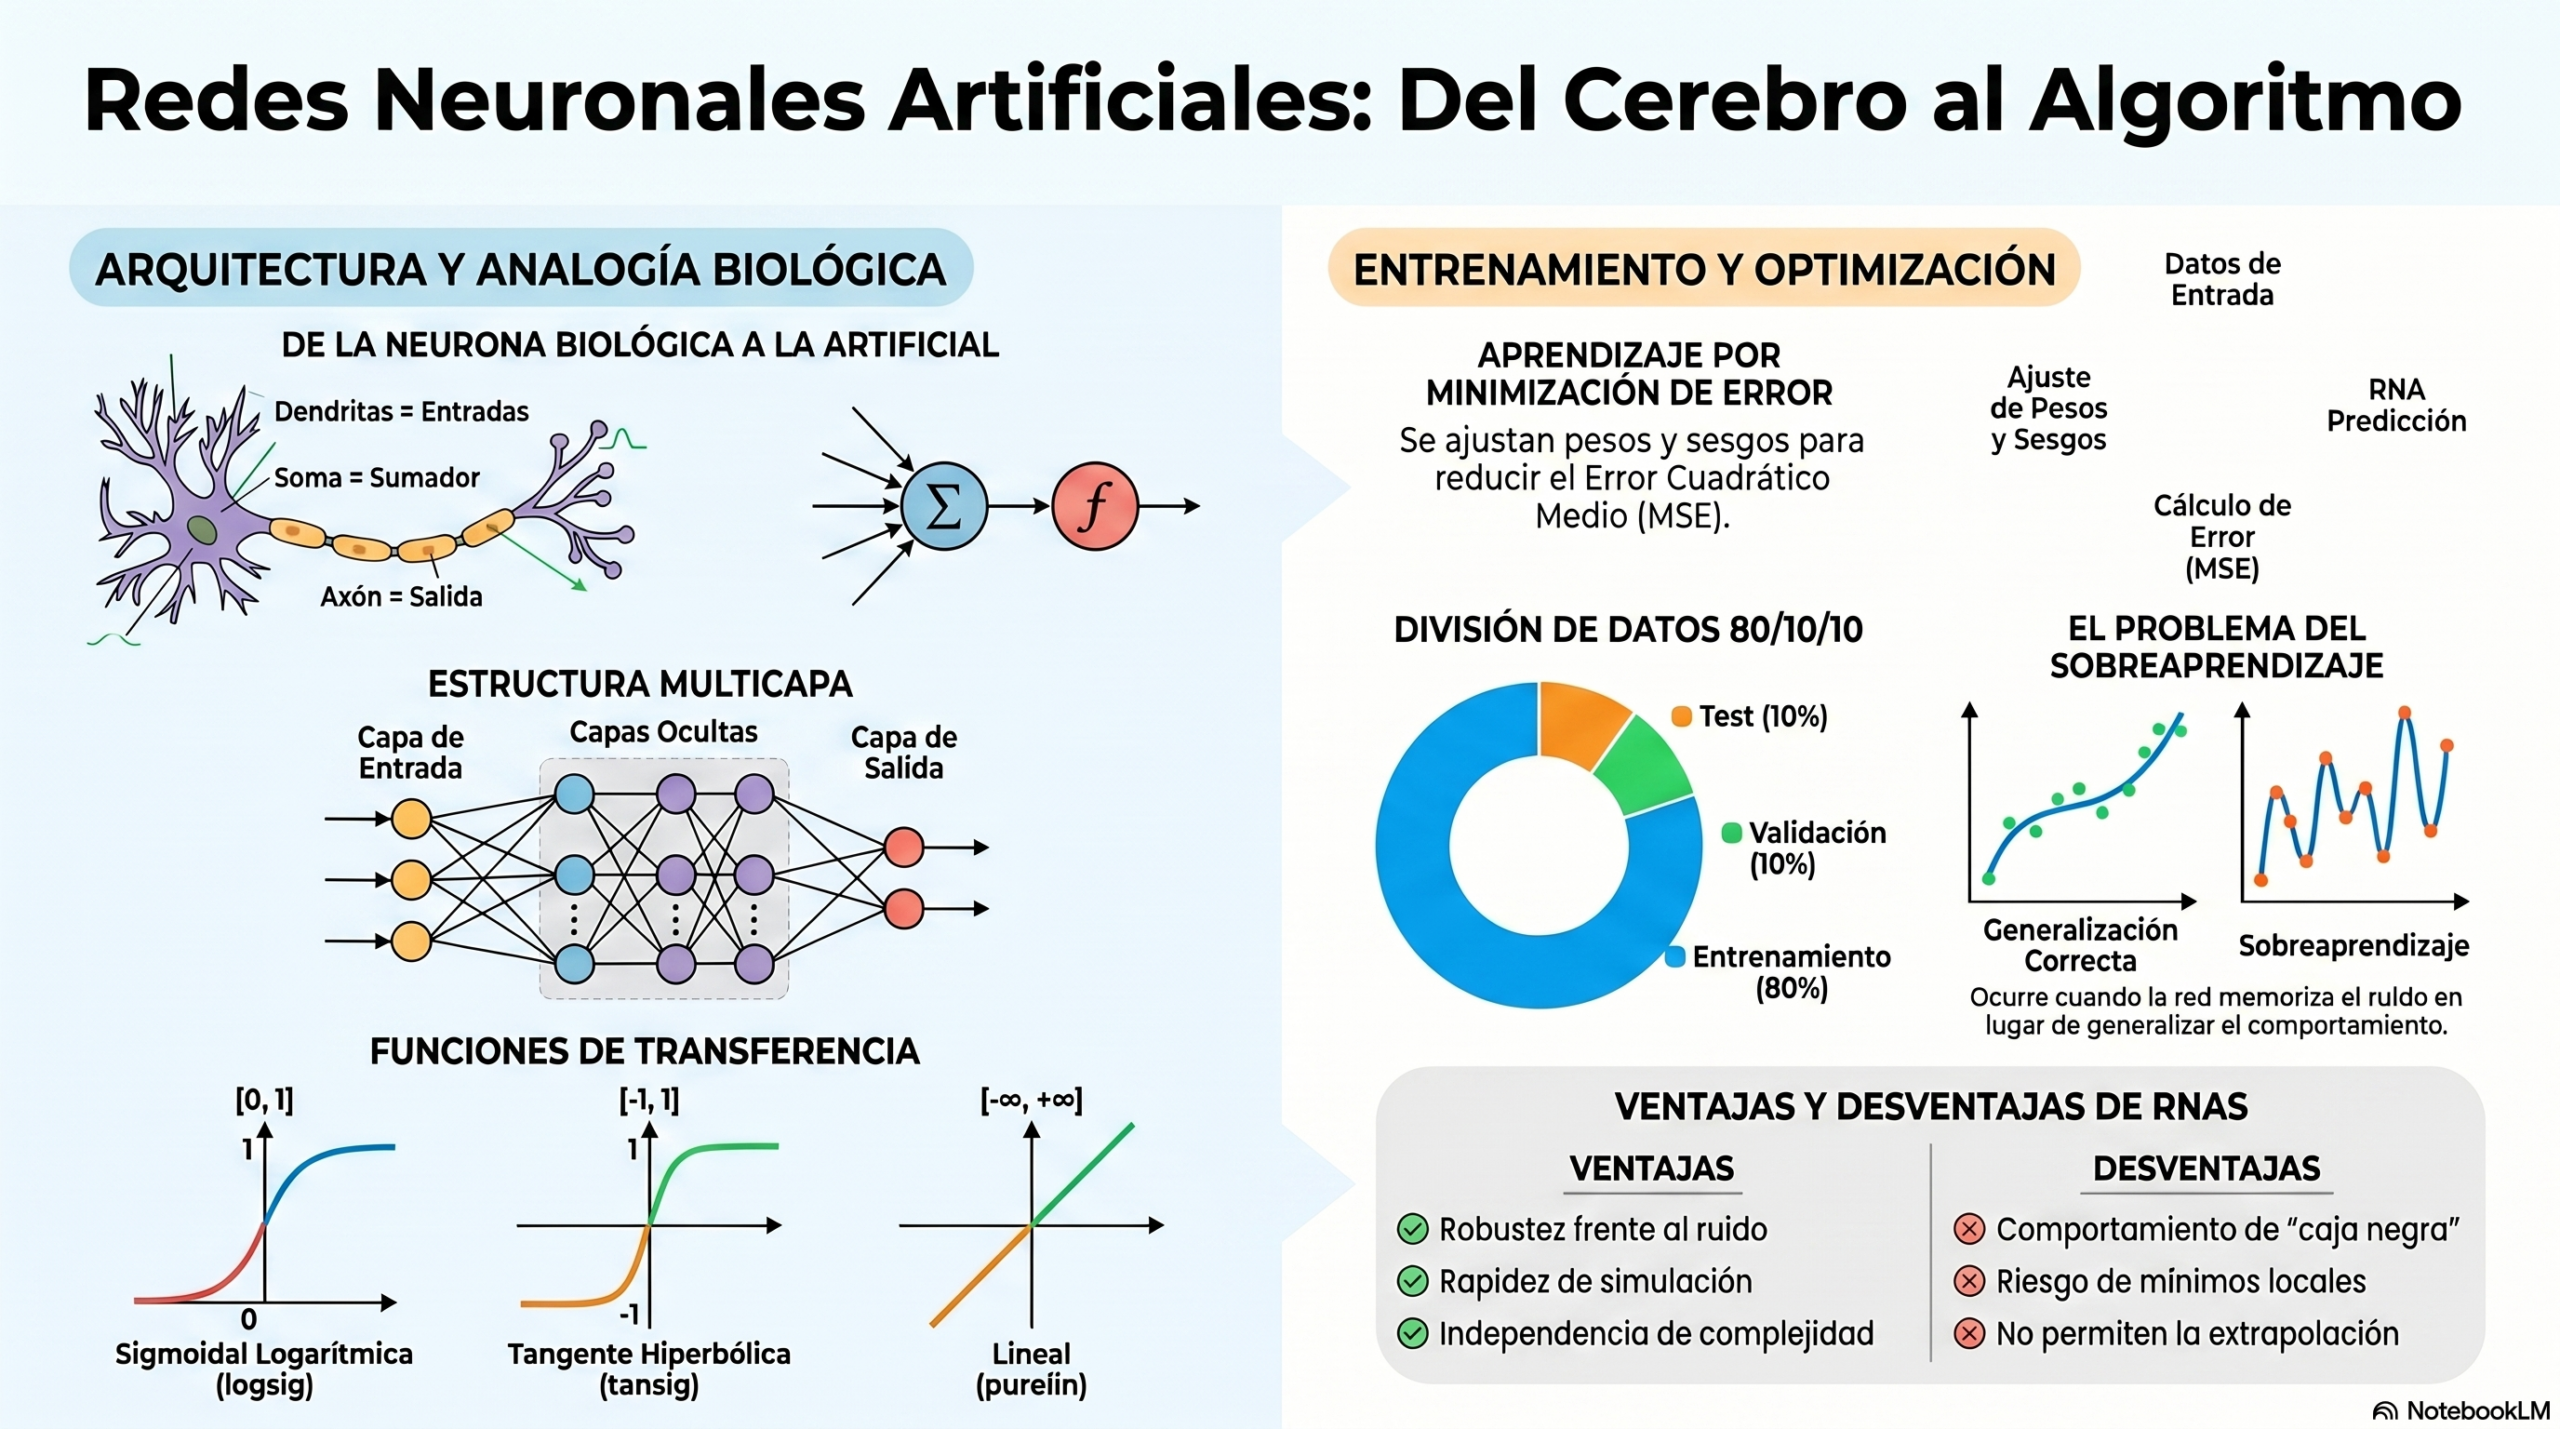
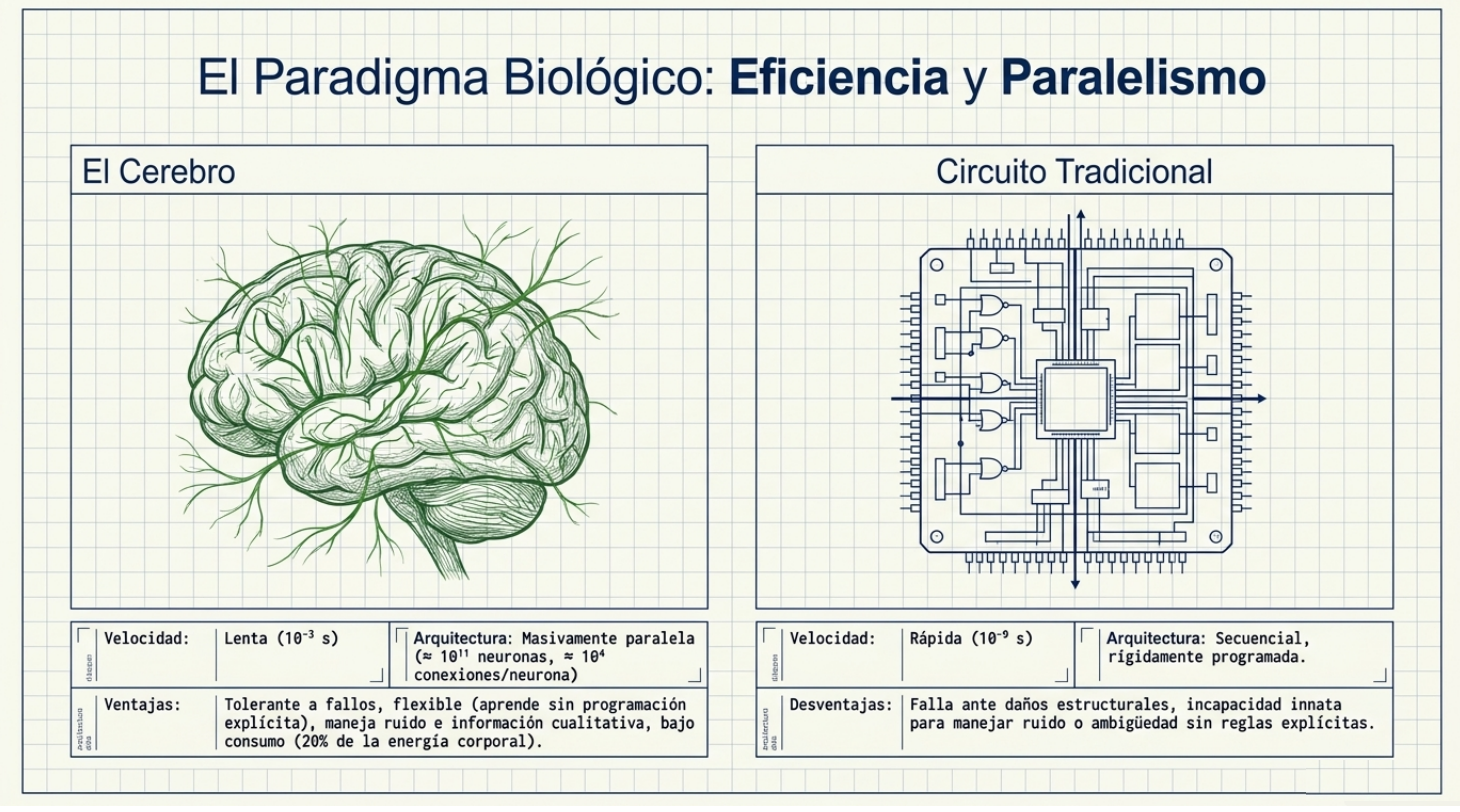
El cerebro biológico representa la cúspide de la eficiencia evolutiva. Es un sistema capaz de procesar información con ruido, manejar datos inconsistentes y, lo más sorprendente, mantener su integridad operativa a pesar de la pérdida constante de unidades individuales.

En el auge de la inteligencia artificial moderna, las Redes Neuronales Artificiales (ANN) no surgen como meras calculadoras, sino como un espejo de silicio que busca replicar esa genialidad orgánica.

Estas redes no se basan en una programación rígida de causa-efecto, sino que «aprenden» a través de la experiencia y la reconfiguración de sus estados, transformando problemas abstractos en soluciones tangibles.

En otros artículos de este blog ya hemos hablado de este tema:

¿Qué es y para qué sirve una red neuronal artificial?

Redes neuronales aplicadas al diseño multiobjetivo de puentes postesados

Redes neuronales y metamodelos Kriging para la optimización de la energía en puentes losa pretensados

La Paradoja de la velocidad: neuronas biológicas frente a circuitos de silicio

Existe una disparidad fascinante entre el hardware biológico y el artificial. Una neurona biológica es intrínsecamente lenta, operando en una escala de milisegundos (10-3 s). En contraste, los circuitos eléctricos de silicio son un millón de veces más veloces, alcanzando los nanosegundos (10-9 s). Sin embargo, el cerebro humano aventaja a la máquina mediante un procesamiento masivamente paralelo, orquestado por aproximadamente 1011 neuronas y una red de 10.000 conexiones por cada una de ellas.

Para que las redes artificiales alcancen una efectividad real en la aproximación de funciones complejas, deben adoptar esta arquitectura paralela. Como especialistas, valoramos una lección fundamental de la biología: la robustez ante el fallo. En la naturaleza, «el cerebro es robusto; pueden morir neuronas sin que el rendimiento global se vea afectado«. Las redes artificiales aspiran a esta misma resiliencia, en la que la inteligencia no depende de un solo nodo, sino de la colectividad.

El conocimiento es un estado, no un lugar

En la computación tradicional, la información se almacena en una dirección de memoria específica, como un libro en un estante. En una red neuronal, el conocimiento es un concepto etéreo que reside en la interacción concertada entre sus componentes. No existe un lugar físico para un «dato»; el aprendizaje está codificado en la arquitectura y en la fuerza de las conexiones.

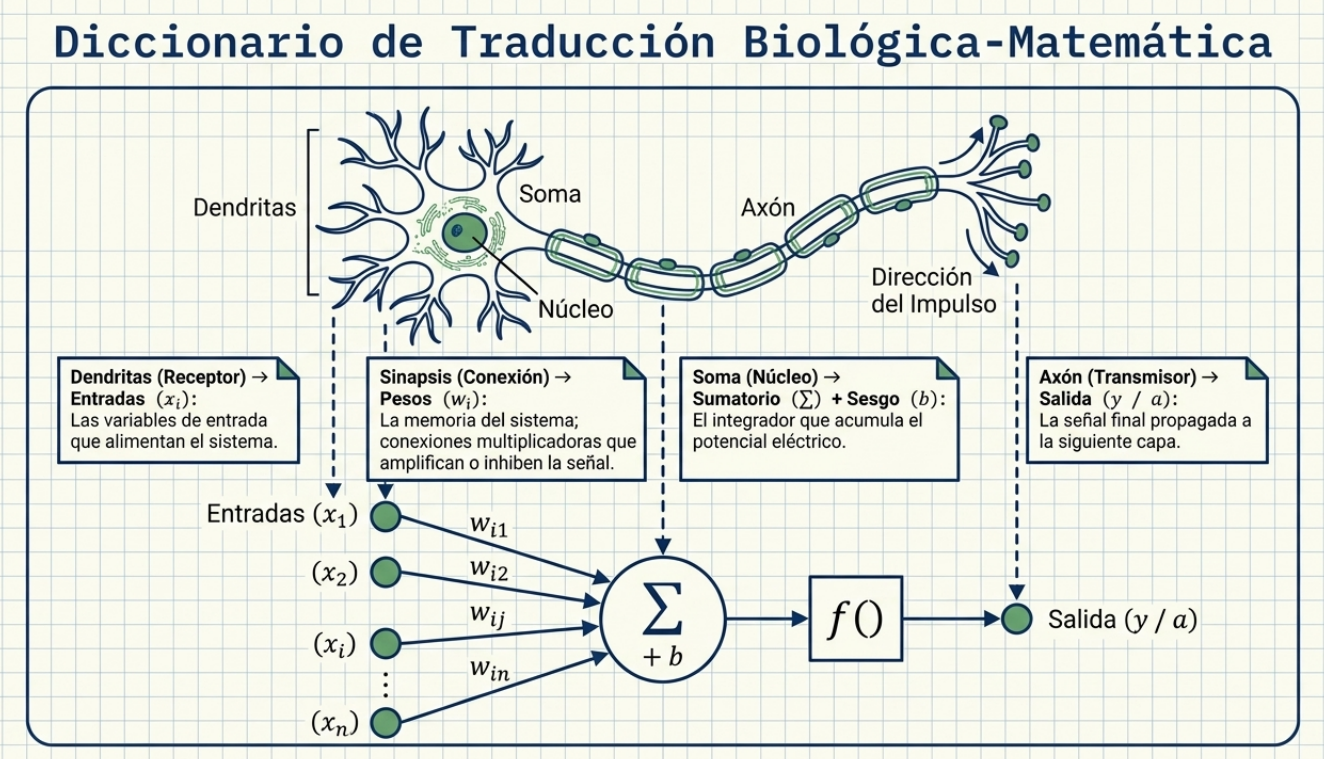
Este sistema se inspira en tres componentes fundamentales que definen el flujo de información:

  • Dendritas (receptores): Fibras nerviosas que actúan como canales de entrada, captando señales de neuronas adyacentes para cargar el soma con un potencial eléctrico.
  • Soma (procesador): El núcleo celular que integra y suma todas las señales recibidas. En IA, esto se traduce en multiplicadores (pesos) y en sumadores.
  • Axón (transmisor): Una fibra cuya longitud varía de milímetros a varios metros, encargada de conducir el impulso si se supera un umbral de activación.

Un detalle técnico que suele pasar desapercibido es que la longitud de la sinapsis —el punto de contacto entre neuronas— está determinada por la complejidad del proceso químico que asegura la función de la red. En la IA, emulamos esto ajustando los «pesos» para fortalecer o inhibir señales, lo que permite que el sistema se autoorganice.

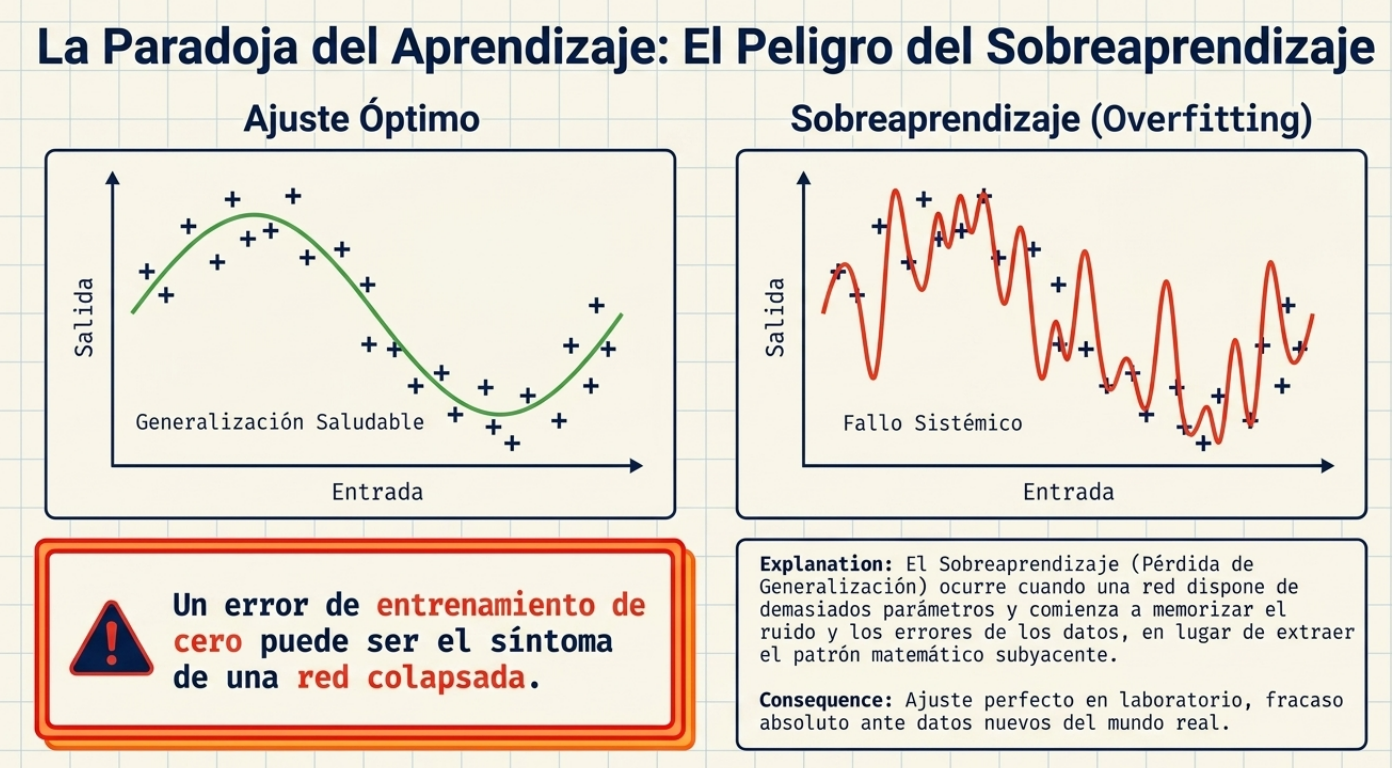
La paradoja del aprendizaje: cuando la memorización asfixia la inteligencia

Aprender en exceso es, a menudo, el camino más rápido hacia el fracaso. Este fenómeno, conocido como overfitting o sobreaprendizaje, ocurre cuando la red memoriza los datos de entrenamiento —incluyendo su ruido y errores— en lugar de comprender el patrón subyacente. Una red «sobreentrenada» es incapaz de generalizar ante datos nuevos, lo que la convierte en una herramienta inútil para la predicción real.

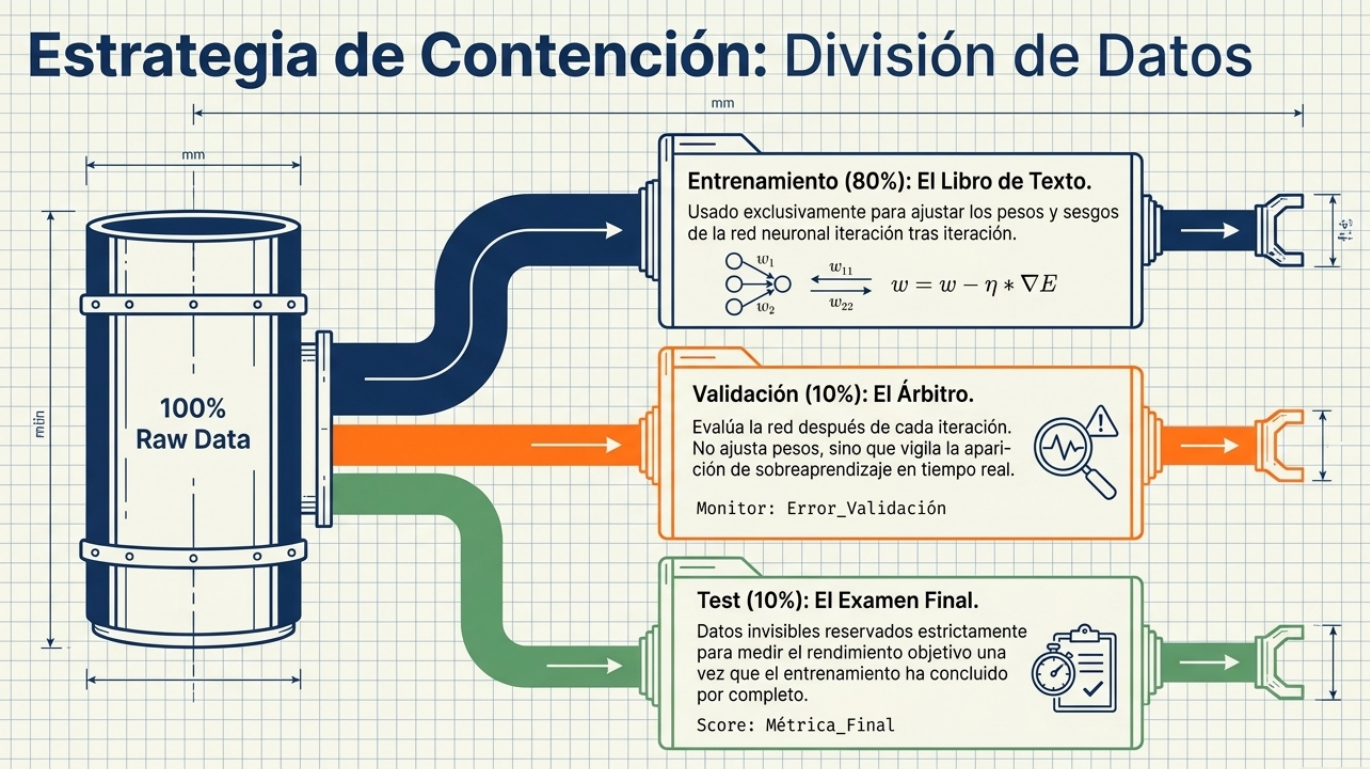
La solución de arquitectura más elegante es el early-stopping (parada temprana). Este proceso monitorea el error en un conjunto de validación y detiene el entrenamiento en el momento exacto en que el error comienza a aumentar, antes de que la red se vuelva demasiado rígida. Para garantizar el éxito, aplicamos la regla del 80/10/10:

  • 80 % de entrenamiento: para ajustar pesos y sesgos.
  • 10 % de validación: para detectar el punto óptimo de detención.
  • 10 % de test: una evaluación final totalmente «ciega» para verificar la capacidad real del modelo.

La Navaja de Ockham en la IA: El poder de «podar» la red

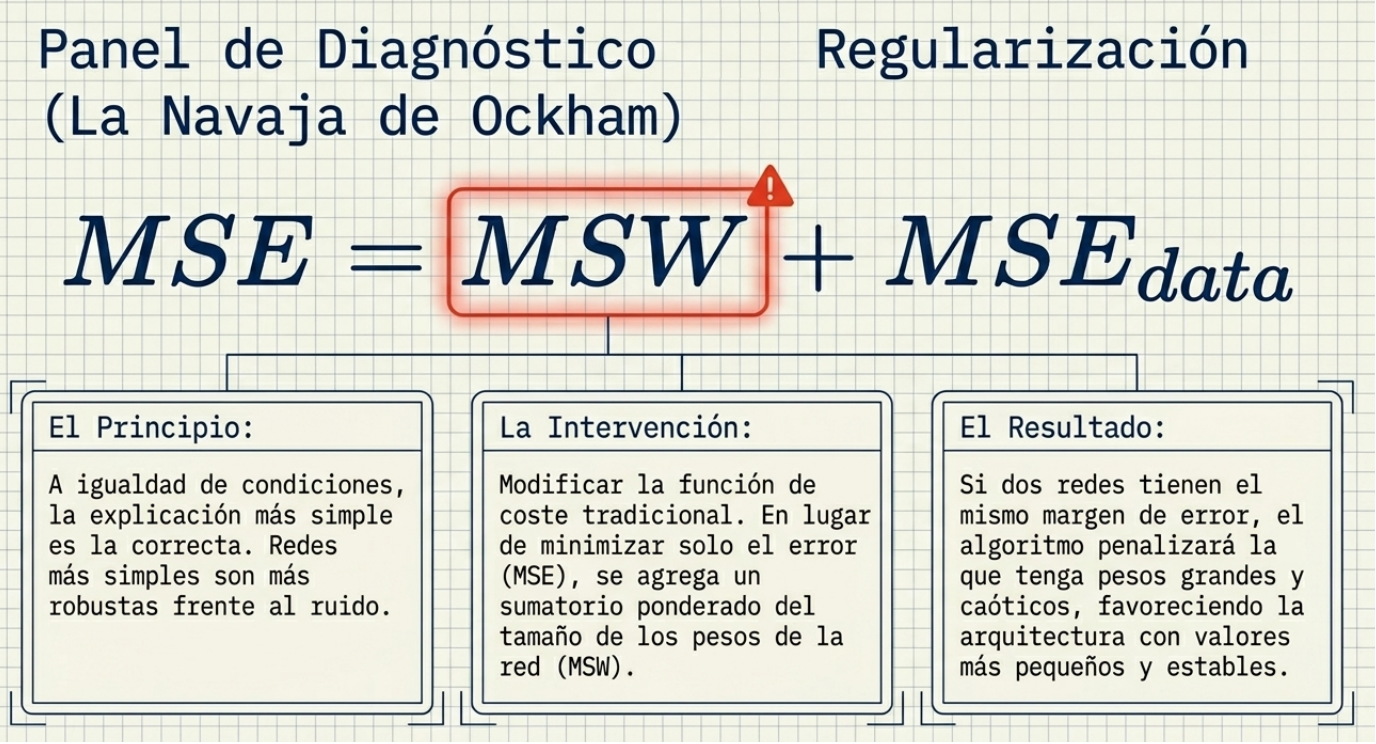
El principio de parsimonia sugiere que la explicación más simple suele ser la más acertada. En el diseño de redes, esto se traduce en redes podadas (pruned networks). Mediante la desconexión de neuronas redundantes o la eliminación de variables de entrada irrelevantes, logramos modelos más compactos y robustos.

Para guiar este proceso, utilizamos dos métricas críticas en la función de coste:

  1. MSE (Mean Squared Error): Su propósito conceptual es penalizar las diferencias entre el valor real y el calculado, elevándolas al cuadrado para dar prioridad matemática a la eliminación de los errores más grandes.
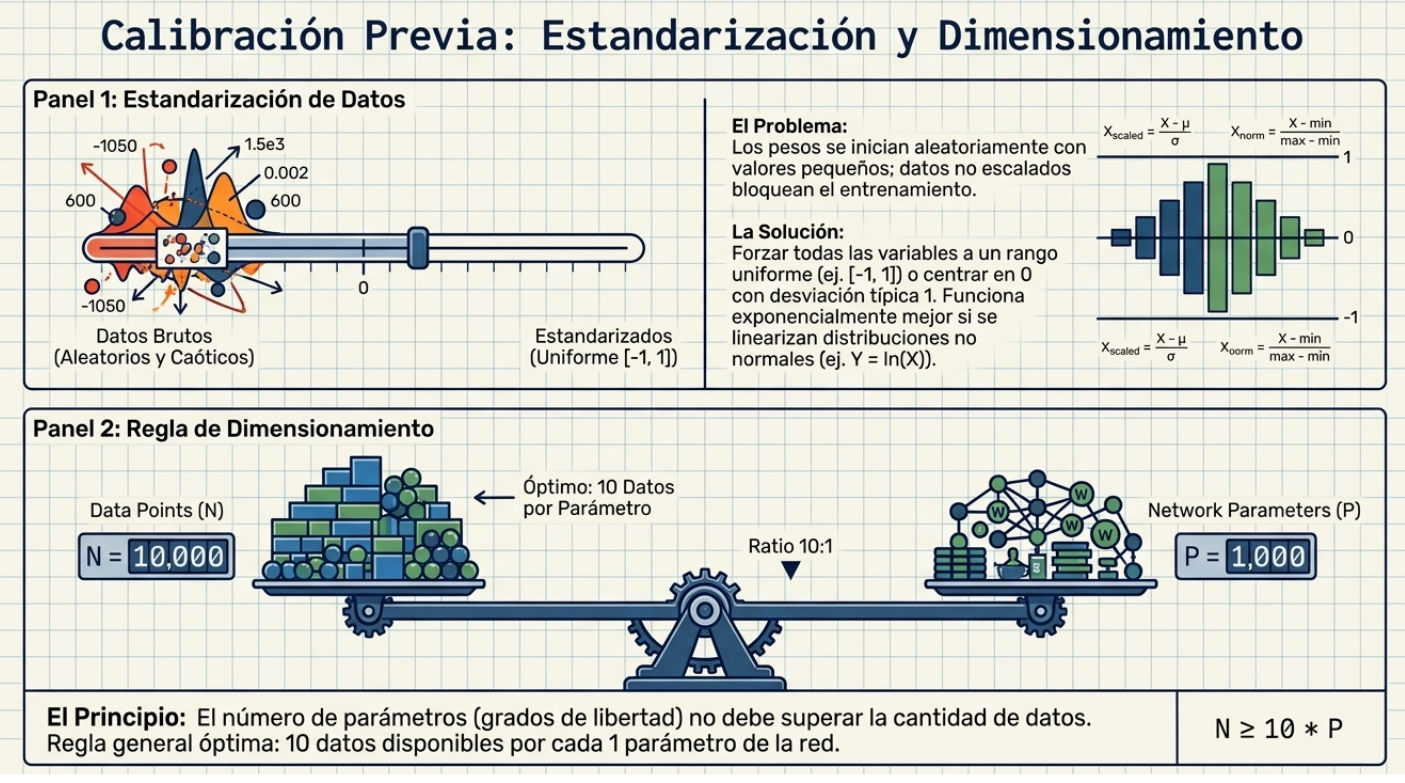
  2. PSE (Predicted Squared Error): Mientras que el MSE mide el error presente, el PSE penaliza activamente el número de parámetros de la red. Su fórmula, PSE = MSE \cdot (1 + 2p/(N-p)), asegura que no estemos añadiendo complejidad innecesaria, castigando los modelos con demasiados grados de libertad en relación con el número de datos disponibles.

El secreto está en la escala: por qué la estandarización es crucial

Aunque las redes neuronales son aproximadores universales, su entrenamiento puede resultar exasperantemente lento o fallar si no se cuida la escala de los datos. Los pesos de una red se inicializan con valores aleatorios pequeños; por ello, si las entradas son masivas, se producen errores iniciales gigantescos que saturan el sistema. Estandarizar los datos en rangos similares —como [-1, 1]— permite que el algoritmo de optimización converja con rapidez.

Además, si una variable presenta una distribución no lineal (como la exponencial), es imperativo linearizarla mediante logaritmos para facilitar el aprendizaje. No obstante, el mayor reto del arquitecto de IA es evitar los mínimos locales: soluciones subóptimas que parecen el fin del camino, pero no son el mejor resultado posible. La inicialización aleatoria y la estandarización son, en última instancia, estrategias para que la red «explore» el paisaje de soluciones sin quedar atrapada en los baches del error.

Conclusión: El laboratorio virtual y el futuro del diseño

Una red neuronal bien entrenada se convierte en un laboratorio virtual. En ingeniería, esto permite generar curvas de diseño de alta precisión; por ejemplo, podemos predecir el comportamiento del «rebase» de una estructura hidráulica al variar la «cota de coronación» mientras mantenemos constantes el resto de las variables. Esto nos ofrece una visión profunda de problemas complejos sin los costes de la experimentación física.

Sin embargo, nos enfrentamos a la naturaleza de «caja negra» de estos sistemas. Obtenemos soluciones perfectas, pero la lógica exacta tras miles de conexiones numéricas permanece oculta. Como sociedad tecnológica, nos acercamos a un umbral decisivo: ¿Estamos dispuestos a confiar plenamente en soluciones óptimas aunque no comprendamos exactamente el proceso intelectual que la red siguió para alcanzarlas? El futuro del diseño no solo depende de la potencia de cálculo, sino también de nuestra capacidad para convivir con esta nueva forma de inteligencia opaca pero infalible.

En esta conversación podéis escuchar las ideas más interesantes sobre estas redes neuronales.

Este vídeo resume bien los conceptos más importantes.

The_Neural_Blueprint

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.

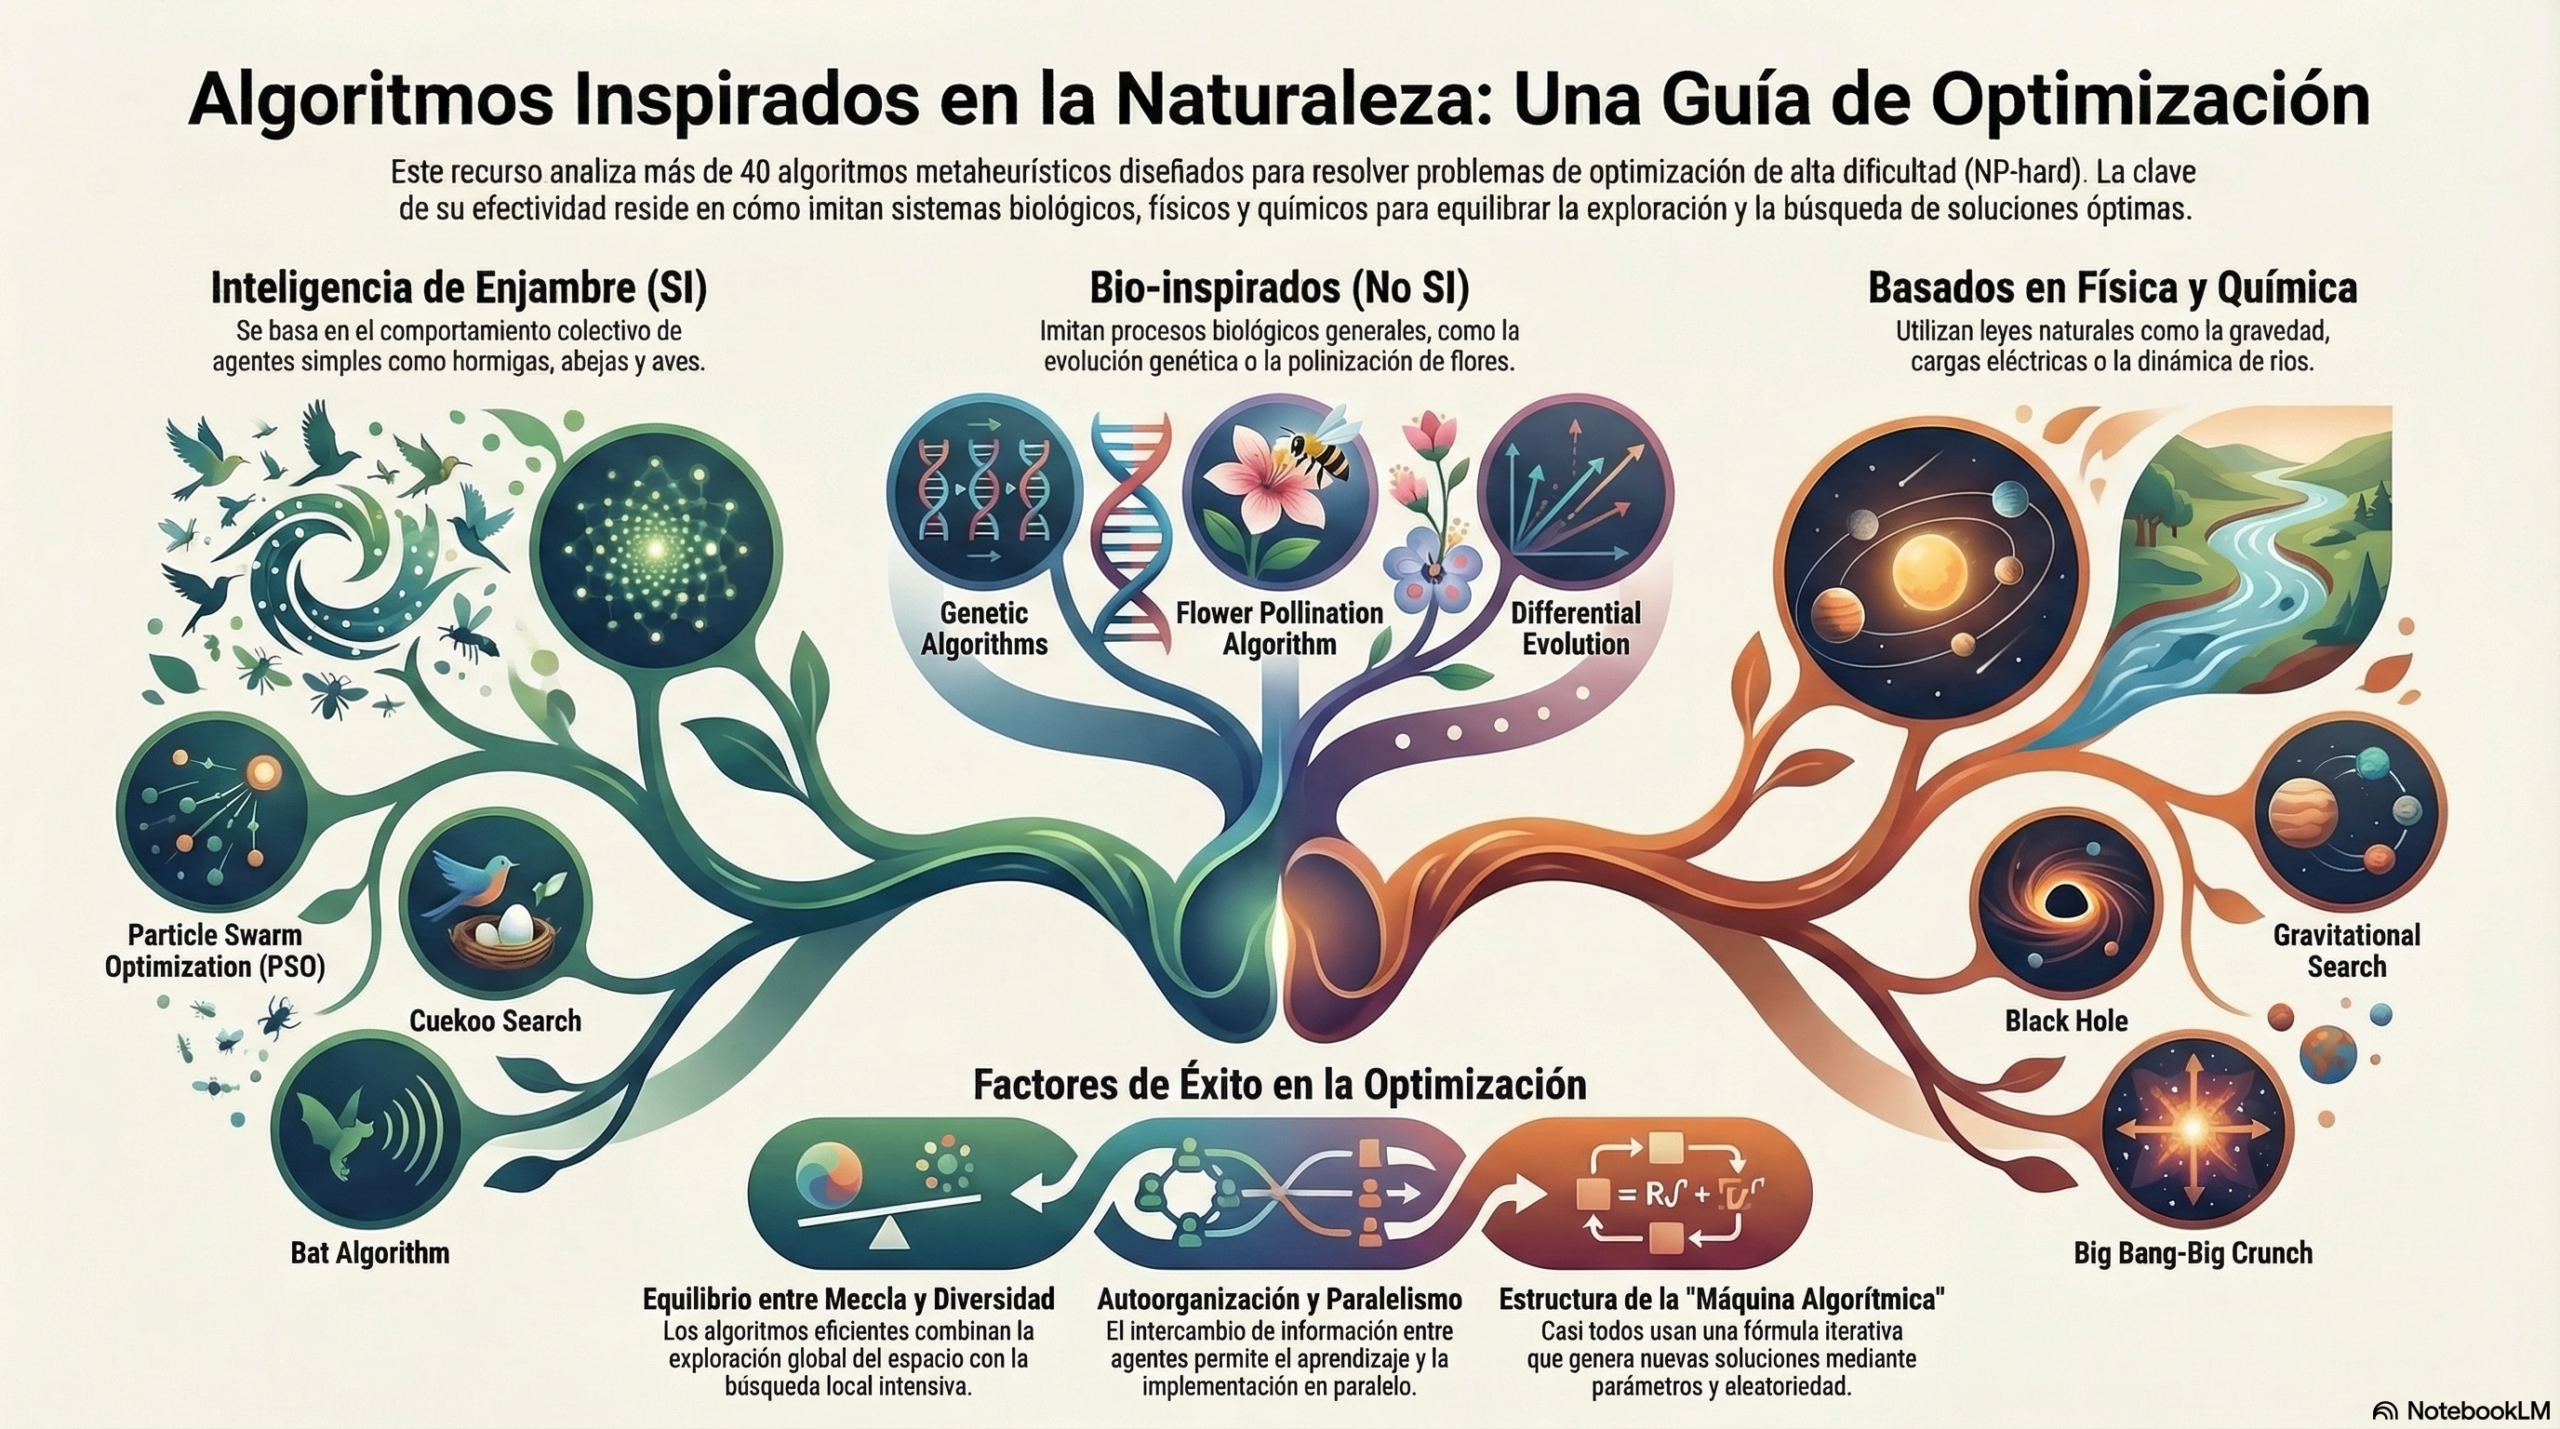
El código secreto de la naturaleza: algoritmos metaheurísticos para resolver lo imposible.

Introducción: El genio oculto en el caos natural.

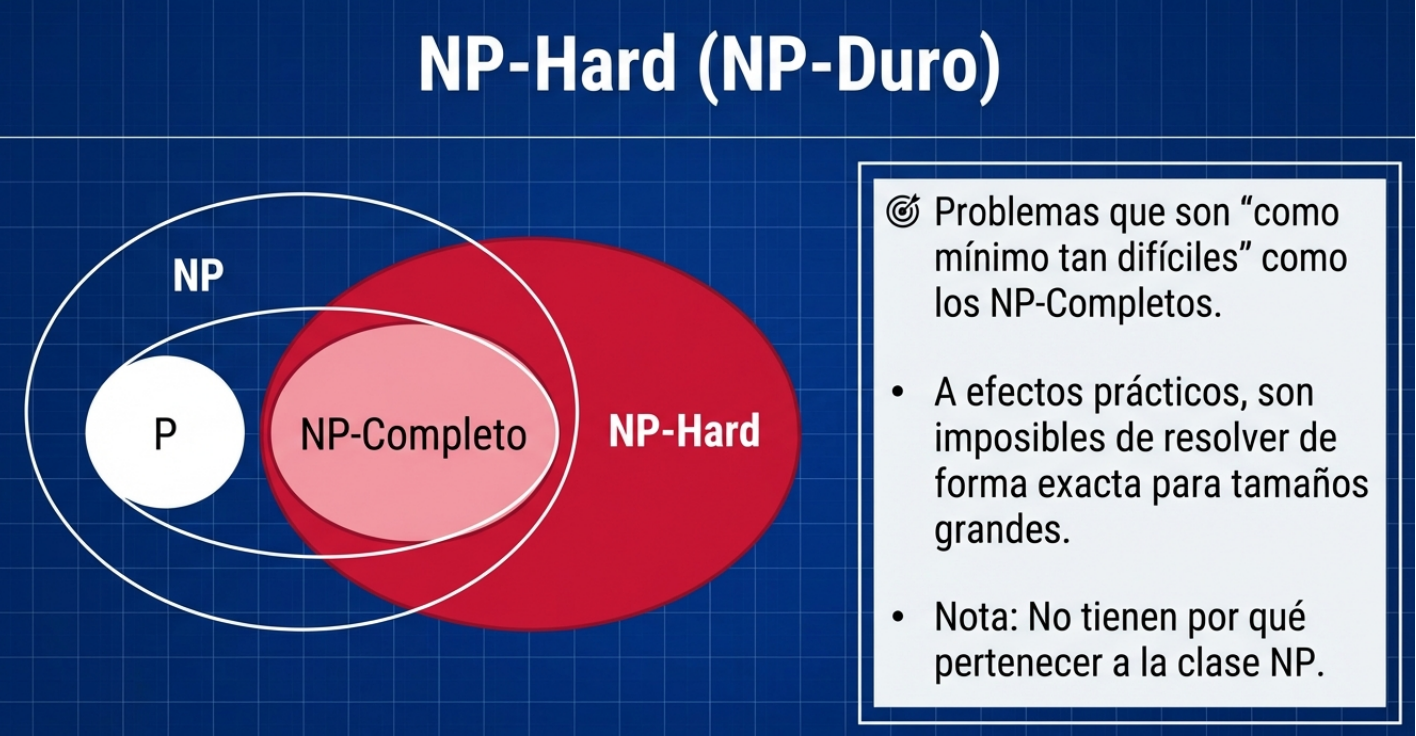
En el vasto universo de la gestión de situaciones complejas, nos enfrentamos a desafíos que cuestionan la lógica convencional: los problemas NP-difíciles.

Estos enigmas se caracterizan por que, a medida que el tamaño del problema aumenta, el tiempo necesario para resolverlo mediante fuerza bruta crece de manera exponencial. Esto hace que una búsqueda exhaustiva sea prácticamente imposible, incluso para las supercomputadoras más potentes. De este modo, cuando los métodos deterministas fallan y no hay garantía de hallar la solución perfecta, los expertos recurren a las metaheurísticas.

Al observar cómo la naturaleza optimiza los recursos para la supervivencia, hemos descubierto que el ensayo y el error no son fruto del azar, sino de un diseño refinado a lo largo de milenios de evolución. Los investigadores han dejado de mirar exclusivamente las pizarras para descifrar el genio oculto en los sistemas biológicos, físicos y químicos y han traducido procesos naturales en ecuaciones de optimización asombrosamente eficientes.

La inteligencia de enjambre: el poder de la multitud «sin inteligencia».

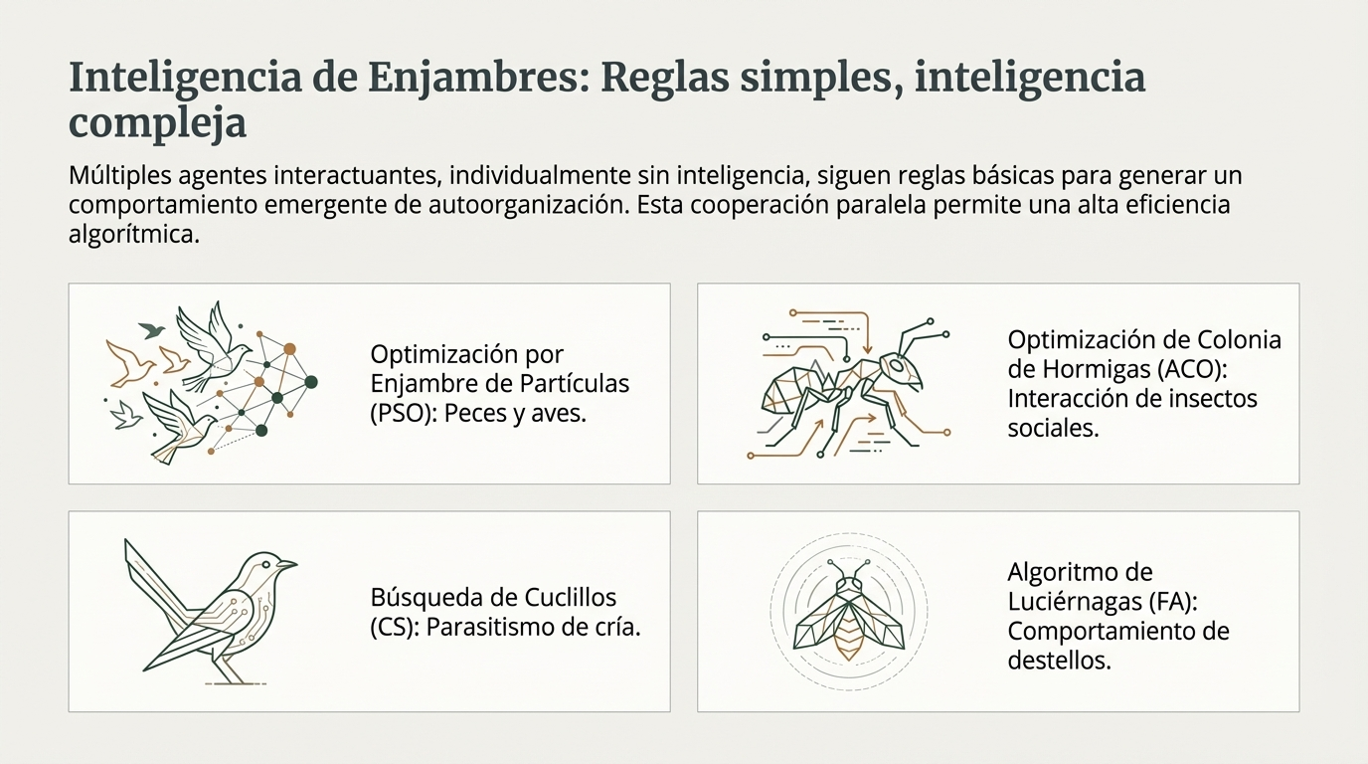
Uno de los pilares más fascinantes de esta disciplina es la inteligencia de enjambre (SI, por sus siglas en inglés). Este concepto se basa en el comportamiento colectivo emergente de múltiples agentes que interactúan según reglas muy sencillas. Ya sea en colonias de hormigas, enjambres de abejas o destellos de luciérnagas, el sistema logra una autorganización compleja sin necesidad de un mando central.

Lo más sorprendente es cómo la capacidad del colectivo trasciende las limitaciones del individuo. Un solo agente puede ser limitado, pero el enjambre, como unidad, exhibe una gran capacidad para resolver problemas. Como señala la literatura académica sobre este fenómeno:

«Aunque cada agente puede ser considerado como ininteligente, el sistema completo de múltiples agentes puede mostrar un comportamiento de autoorganización y, por lo tanto, puede comportarse como una suerte de inteligencia colectiva».

Más allá de la biología: la optimización se encuentra con la física y la música.

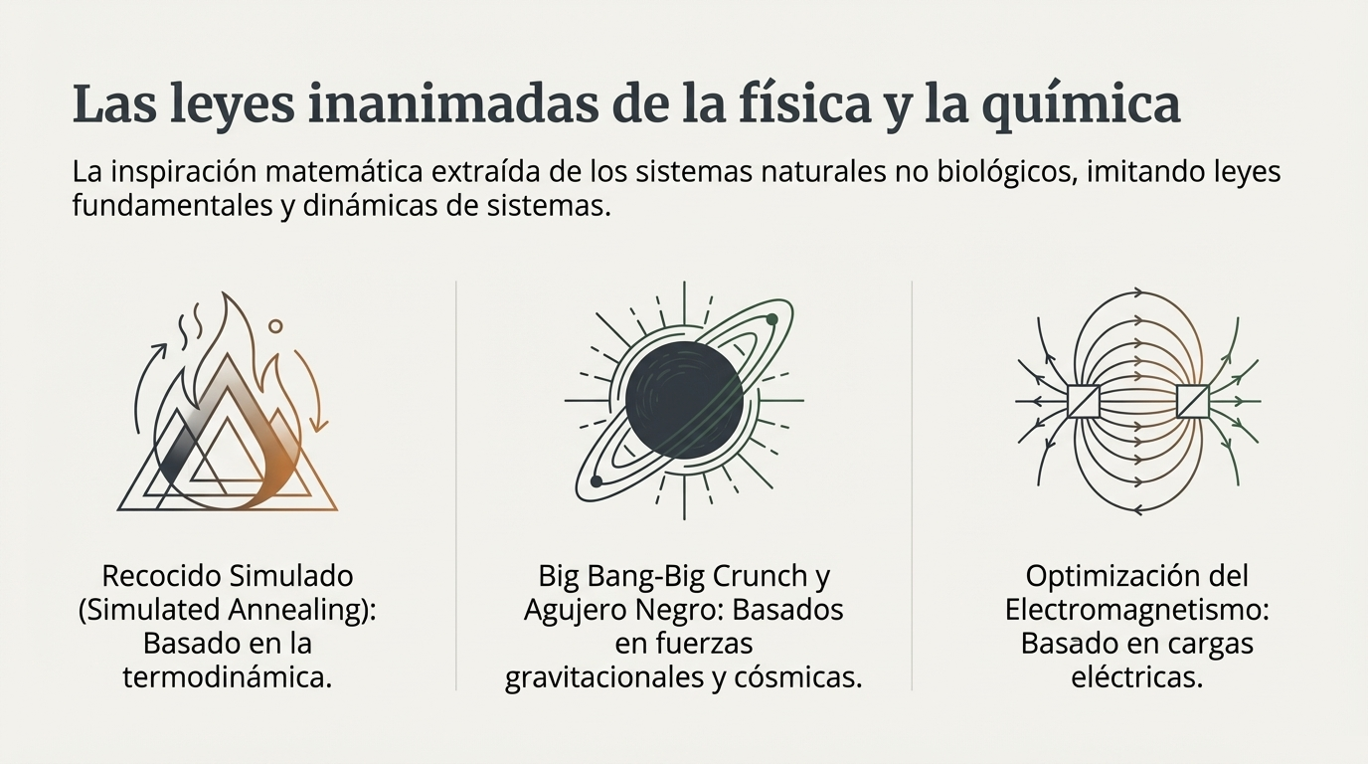
Aunque la biología es una fuente muy rica, la informática inspirada en la naturaleza trasciende mucho más. Para un especialista, la clasificación de estos algoritmos no se limita a su «musa», sino a su comportamiento matemático. Podemos categorizarlos según su trayectoria de búsqueda (como el Simulated Annealing) o según si se basan en poblaciones (como el Particle Swarm Optimization o el Firefly Algorithm).

Existen sistemas basados en leyes físicas y químicas, como los algoritmos que imitan la fuerza de la gravedad, las cargas eléctricas o la dinámica de formación de ríos. Incluso el arte tiene su lugar en el algoritmo Harmony Search (Búsqueda Armónica), que imita el proceso estético de un músico que persigue el «estado de armonía» o el acorde perfecto. Esta universalidad demuestra que los conceptos de disciplinas tan dispares pueden traducirse en reglas de actualización precisas para hallar soluciones casi óptimas en ingeniería y logística.

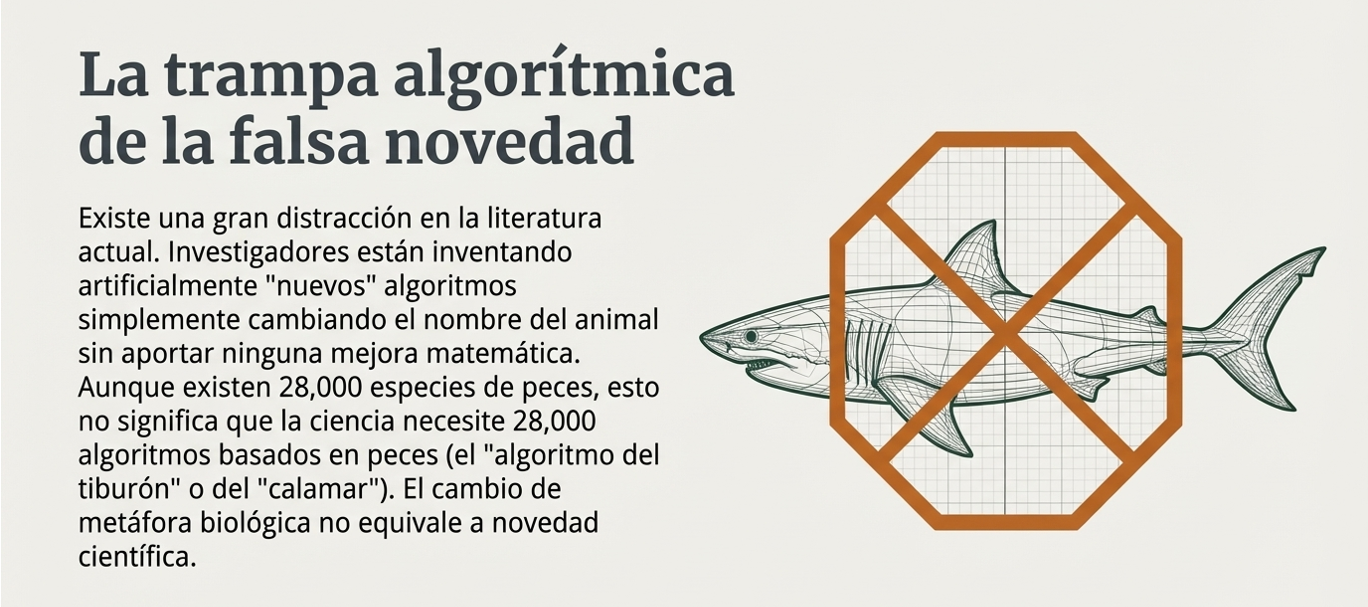
La trampa de las 28 000 especies: el desafío de la verdadera novedad.

A pesar del auge de estas técnicas, la comunidad científica se enfrenta a una realidad crítica: la proliferación de algoritmos que carecen de innovación real. Aunque en el mundo existen aproximadamente 28 000 especies de peces, esto no justifica la creación de 28 000 variantes algorítmicas (por ejemplo, el algoritmo del tiburón, de la trucha, etc.) que solo cambian los nombres de las variables sin aportar una mejora sustancial al motor de búsqueda.

En los últimos años, el mundo de la optimización ha experimentado una auténtica explosión de metaheurísticas. Nuevos algoritmos “inspirados en la naturaleza” están apareciendo como setas tras la lluvia. Solo en el último lustro, la comunidad científica se ha encontrado con miles de propuestas que se presentan como completamente originales.

El problema es que, en muchos casos, esas supuestas “novedades” no aportan ideas realmente nuevas. Son simplemente variantes, más o menos ingeniosas, de algoritmos ya conocidos y consolidados. Cambia el nombre, cambia la metáfora biológica o social, pero el mecanismo interno apenas difiere del de otros modelos existentes.

La situación ha llegado a tal punto que varias revistas científicas de alto impacto han decidido poner freno a esta tendencia. Muchas de ellas ya no aceptan trabajos que presenten una “nueva metaheurística” si no demuestran aportaciones metodológicas auténticas y verificables.

Esto supone una llamada a la acción para priorizar el rigor por encima de la «marca» comercial del algoritmo. Los expertos advierten sobre el peligro de la «pseudoinnovación» con fines de publicación:

No basta con bautizar un algoritmo con un nombre llamativo; tiene que resolver mejor los problemas reales.

La receta del éxito: mezcla, diversidad y paralelismo.

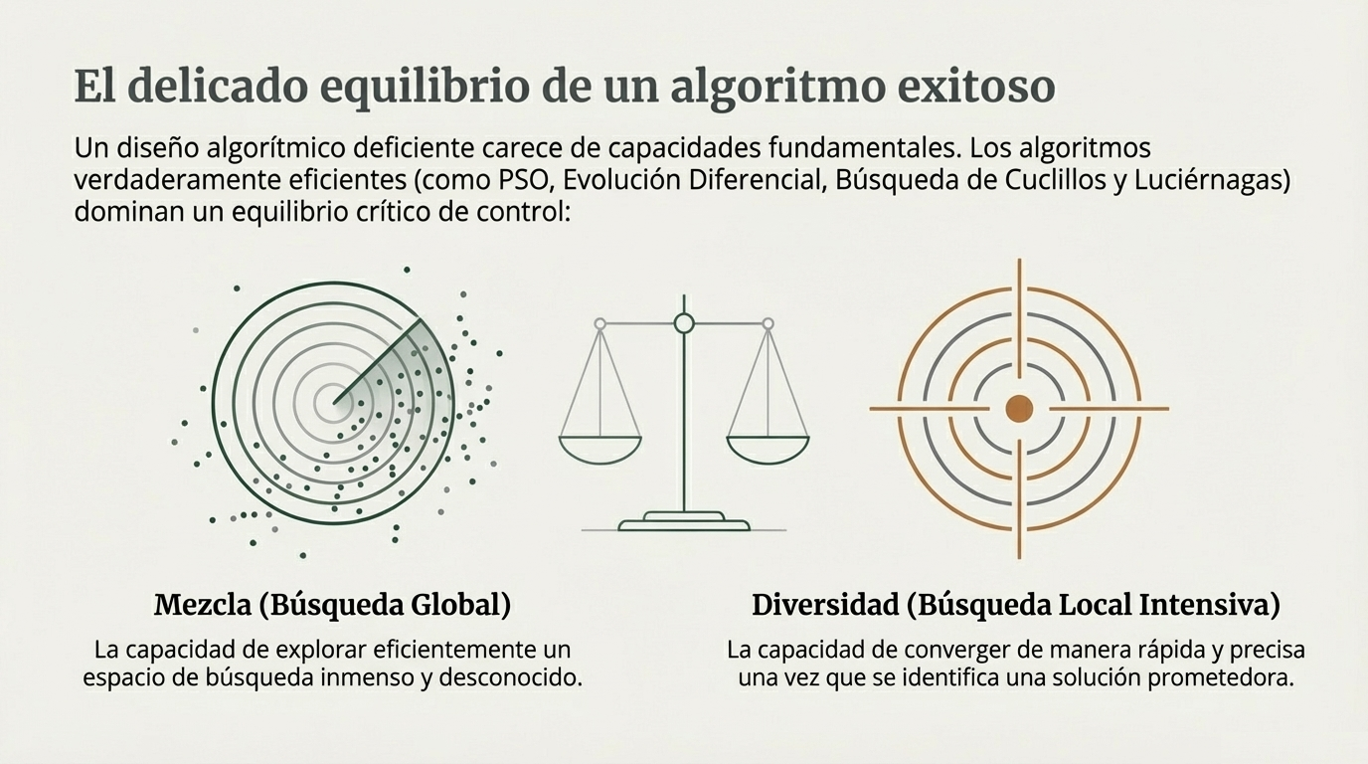
¿Por qué algoritmos como Cuckoo Search o el Firefly Algorithm triunfan, mientras que otros caen en el olvido? El éxito de un metaheurístico radica en su capacidad para equilibrar dos fuerzas opuestas:

  • Diversidad (búsqueda global/exploración): es la capacidad del algoritmo para explorar exhaustivamente el amplio espacio de búsqueda y evitar quedar atrapado en soluciones locales que parecen buenas, pero no lo son.
  • Mezcla (búsqueda local/explotación): es el proceso de recombinación e interacción entre soluciones que permite al algoritmo converger rápidamente hacia el punto óptimo una vez identificada una región prometedora.

Además, una ventaja competitiva de los algoritmos de inteligencia de enjambre es su facilidad de paralelización. Al basarse en múltiples agentes independientes, estos procesos pueden ejecutarse simultáneamente en hardware moderno, lo que permite optimizar problemas a gran escala en el mundo real por primera vez de forma práctica y eficiente.

Conclusión: hacia una nueva era de resolución de problemas.

Los algoritmos inspirados en la naturaleza han dejado de ser una mera curiosidad para convertirse en el estándar de oro para los problemas de alta complejidad. Es por ello que el futuro de esta disciplina no radica en buscar «más especies» que imitar, sino en profundizar en el marco matemático que permite que la diversidad y la mezcla funcionen en armonía. Solo a través de la comprensión real de estos mecanismos podremos hacer frente a los enormes desafíos de la tecnología moderna.

Al observar la elegancia con la que un enjambre encuentra su camino o un sistema físico alcanza el equilibrio, surge una pregunta inevitable: ¿existe algún límite a lo que podemos aprender sobre la eficiencia de la naturaleza o apenas estamos empezando a descifrar su código más fundamental?

En esta conversación puedes escuchar algunas de las ideas más interesantes sobre este tema.

En este vídeo se resumen algunos de los conceptos más importantes abordados.

Fister

Nature_Inspired_Optimization

Referencias:

FISTER JR, I.; YANG, X. S.; FISTER, I.; BREST, J.; FISTER, D. (2013). A brief review of nature‑inspired algorithms for optimization. arXiv preprint arXiv:1307.4186.

GARCÍA, J.; YEPES, V.; MARTÍ, J.V. (2020). A hybrid k-means cuckoo search algorithm applied to the counterfort retaining walls problem. Mathematics,  8(4), 555. DOI:10.3390/math8040555

GARCÍA, J.; MARTÍ, J.V.; YEPES, V. (2020). The buttressed  walls problem: An application of a hybrid clustering particle swarm optimization algorithm. Mathematics,  8(6):862. DOI:10.3390/math8060862

GARCÍA-SEGURA, T.; YEPES, V.; ALCALÁ, J.; PÉREZ-LÓPEZ, E. (2015). Hybrid harmony search for sustainable design of post-tensioned concrete box-girder pedestrian bridges. Engineering Structures, 92:112-122. DOI:10.1016/j.engstruct.2015.03.015

GARCÍA-SEGURA, T.; YEPES, V.; MARTÍ, J.V.; ALCALÁ, J. (2014). Optimization of concrete I-beams using a new hybrid glow-worm swarm algorithm. Latin American Journal of Solids and Structures, 11(7):1190 – 1205. DOI:10.1590/S1679-78252014000700007

YEPES, V.; ALCALÁ, J.; PEREA, C.; GONZÁLEZ-VIDOSA, F. (2008). A Parametric Study of Optimum Earth Retaining Walls by Simulated Annealing. Engineering Structures, 30(3): 821-830. DOI:10.1016/j.engstruct.2007.05.023

YEPES, V. (2026). Heuristic Optimization Using Simulated Annealing. In: Kulkarni, A.J., Mezura-Montes, E., Bonakdari, H. (eds) Encyclopedia of Engineering Optimization and Heuristics. Springer, Singapore. https://doi.org/10.1007/978-981-96-8165-5_48-1

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.
El algoritmo de la naturaleza: El secreto de las hormigas para resolver problemas imposibles

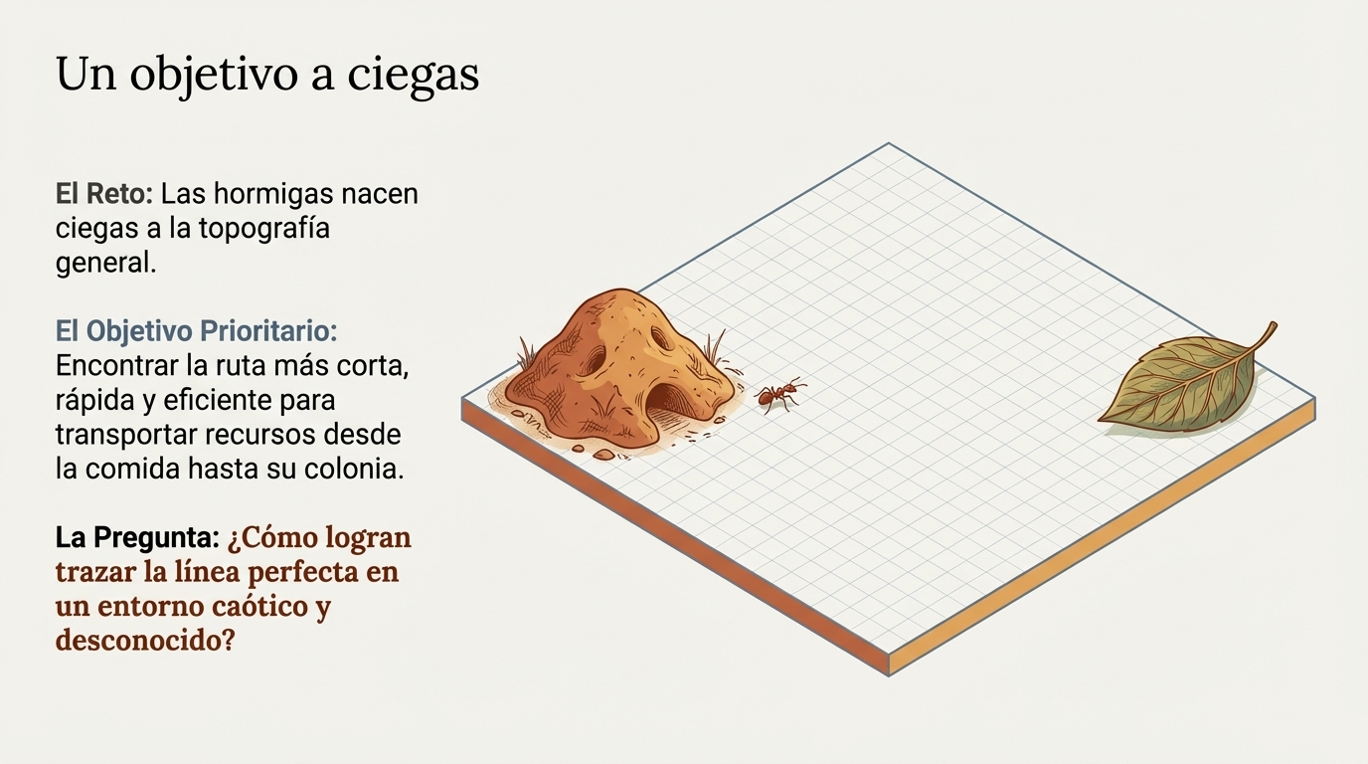
¿Cómo es posible que insectos con capacidades individuales sumamente limitadas resuelvan problemas geométricos y logísticos que a la humanidad le han llevado décadas de estudio formal para dominar?

En el rincón más sencillo de un jardín tiene lugar un fenómeno asombroso: una comunidad de diminutos seres encuentra, sin mapas, líderes jerárquicos ni tecnología GPS, el camino más corto entre un hormiguero y una fuente de alimento.

Este prodigio de la naturaleza no es solo una curiosidad biológica, sino la piedra angular de la optimización mediante colonias de hormigas (ACO), una potente metaheurística computacional que actúa como puente entre la eficiencia orgánica y los algoritmos más avanzados de la actualidad.

A continuación, exploramos cinco lecciones fundamentales que estos optimizadores naturales nos enseñan sobre la resolución de problemas complejos.

La inteligencia no reside en el individuo, sino en el colectivo.

En el mundo de las hormigas, la genialidad no es una cualidad de un «líder» con una visión superior, sino que surge del grupo. Así, el comportamiento inteligente surge de la masa, lo que desafía nuestras nociones tradicionales de gestión jerárquica. La ciencia ha comprobado que la brillantez del sistema no radica en sus componentes aislados, sino en la red de interacciones entre ellos.

Como se describe en los fundamentos de la inteligencia colectiva:

«En la naturaleza existen ejemplos de colectivos de individuos cuyo comportamiento es aparentemente inteligente, sin que esta característica se manifieste en sus componentes individuales».

Esta realidad nos invita a reflexionar sobre un cambio de paradigma: frente al liderazgo humano centralizado, la naturaleza propone una lógica bottom-up, en la que la suma de acciones simples y coordinadas supera la capacidad de cualquier genio individual.

El «Universo» como herramienta de comunicación dinámica.

Para que una colonia resuelva un problema, no es necesario que todas las hormigas conozcan el mapa completo del entorno. De hecho, ningún agente posee un conocimiento global. El éxito depende de la interacción con su «universo», que actúa como depositario físico de la información.

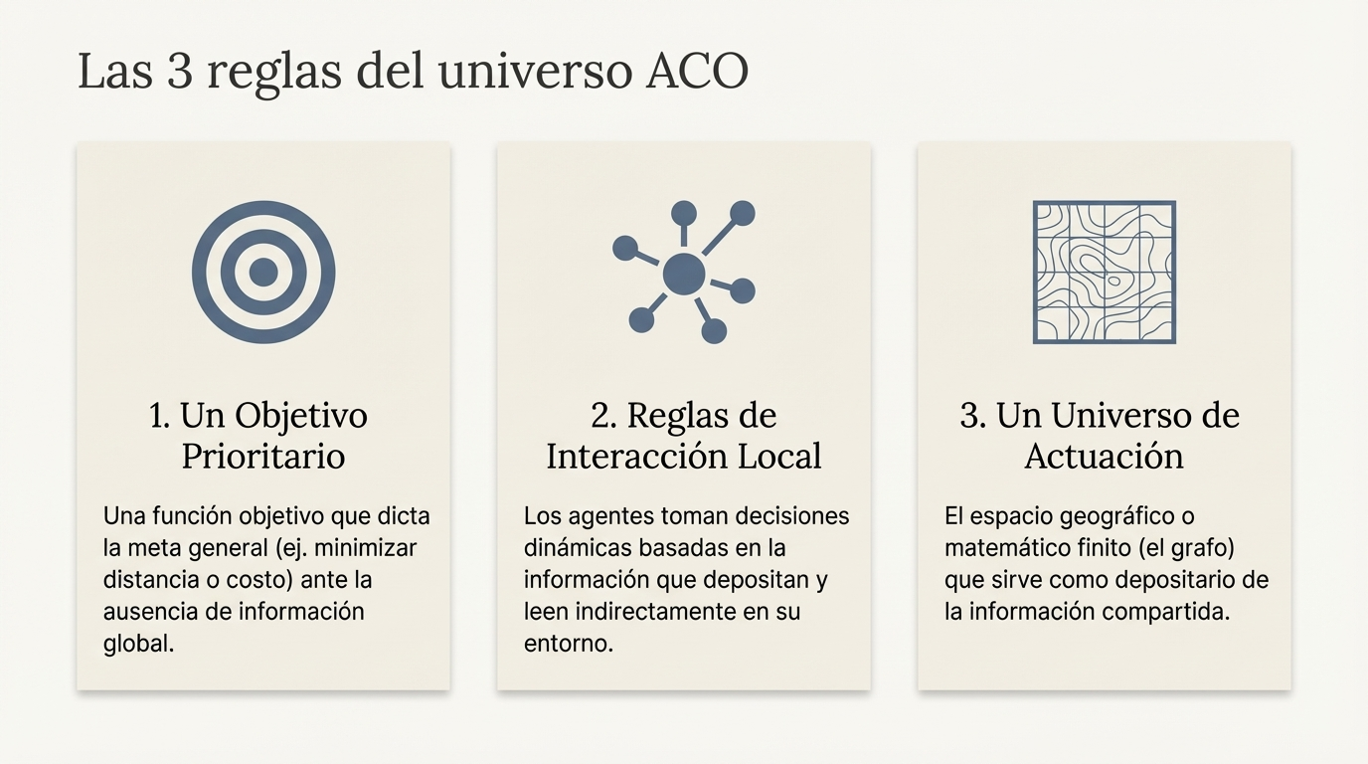
Según el contexto científico, deben cumplirse tres condiciones esenciales para que se produzca este comportamiento:

  • Existencia de un objetivo prioritario: una meta clara (como la locomoción o la alimentación) que proporciona un norte y, crucialmente, dicta el comportamiento de los agentes incluso en ausencia de información local.
  • Reglas de interacción local: si existe información local, el agente la utiliza para tomar decisiones que le permitan alcanzar el objetivo más rápidamente. Los agentes independientes depositan y modifican datos en el entorno, comunicando indirectamente los resultados de sus esfuerzos.
  • Un universo donde actuar: el entorno es la «geografía» por la que transitan. Es el medio que proporciona los datos necesarios y en el que se encuentra la memoria colectiva del sistema.

Feromonas: el rastro que se convierte en memoria adaptativa.

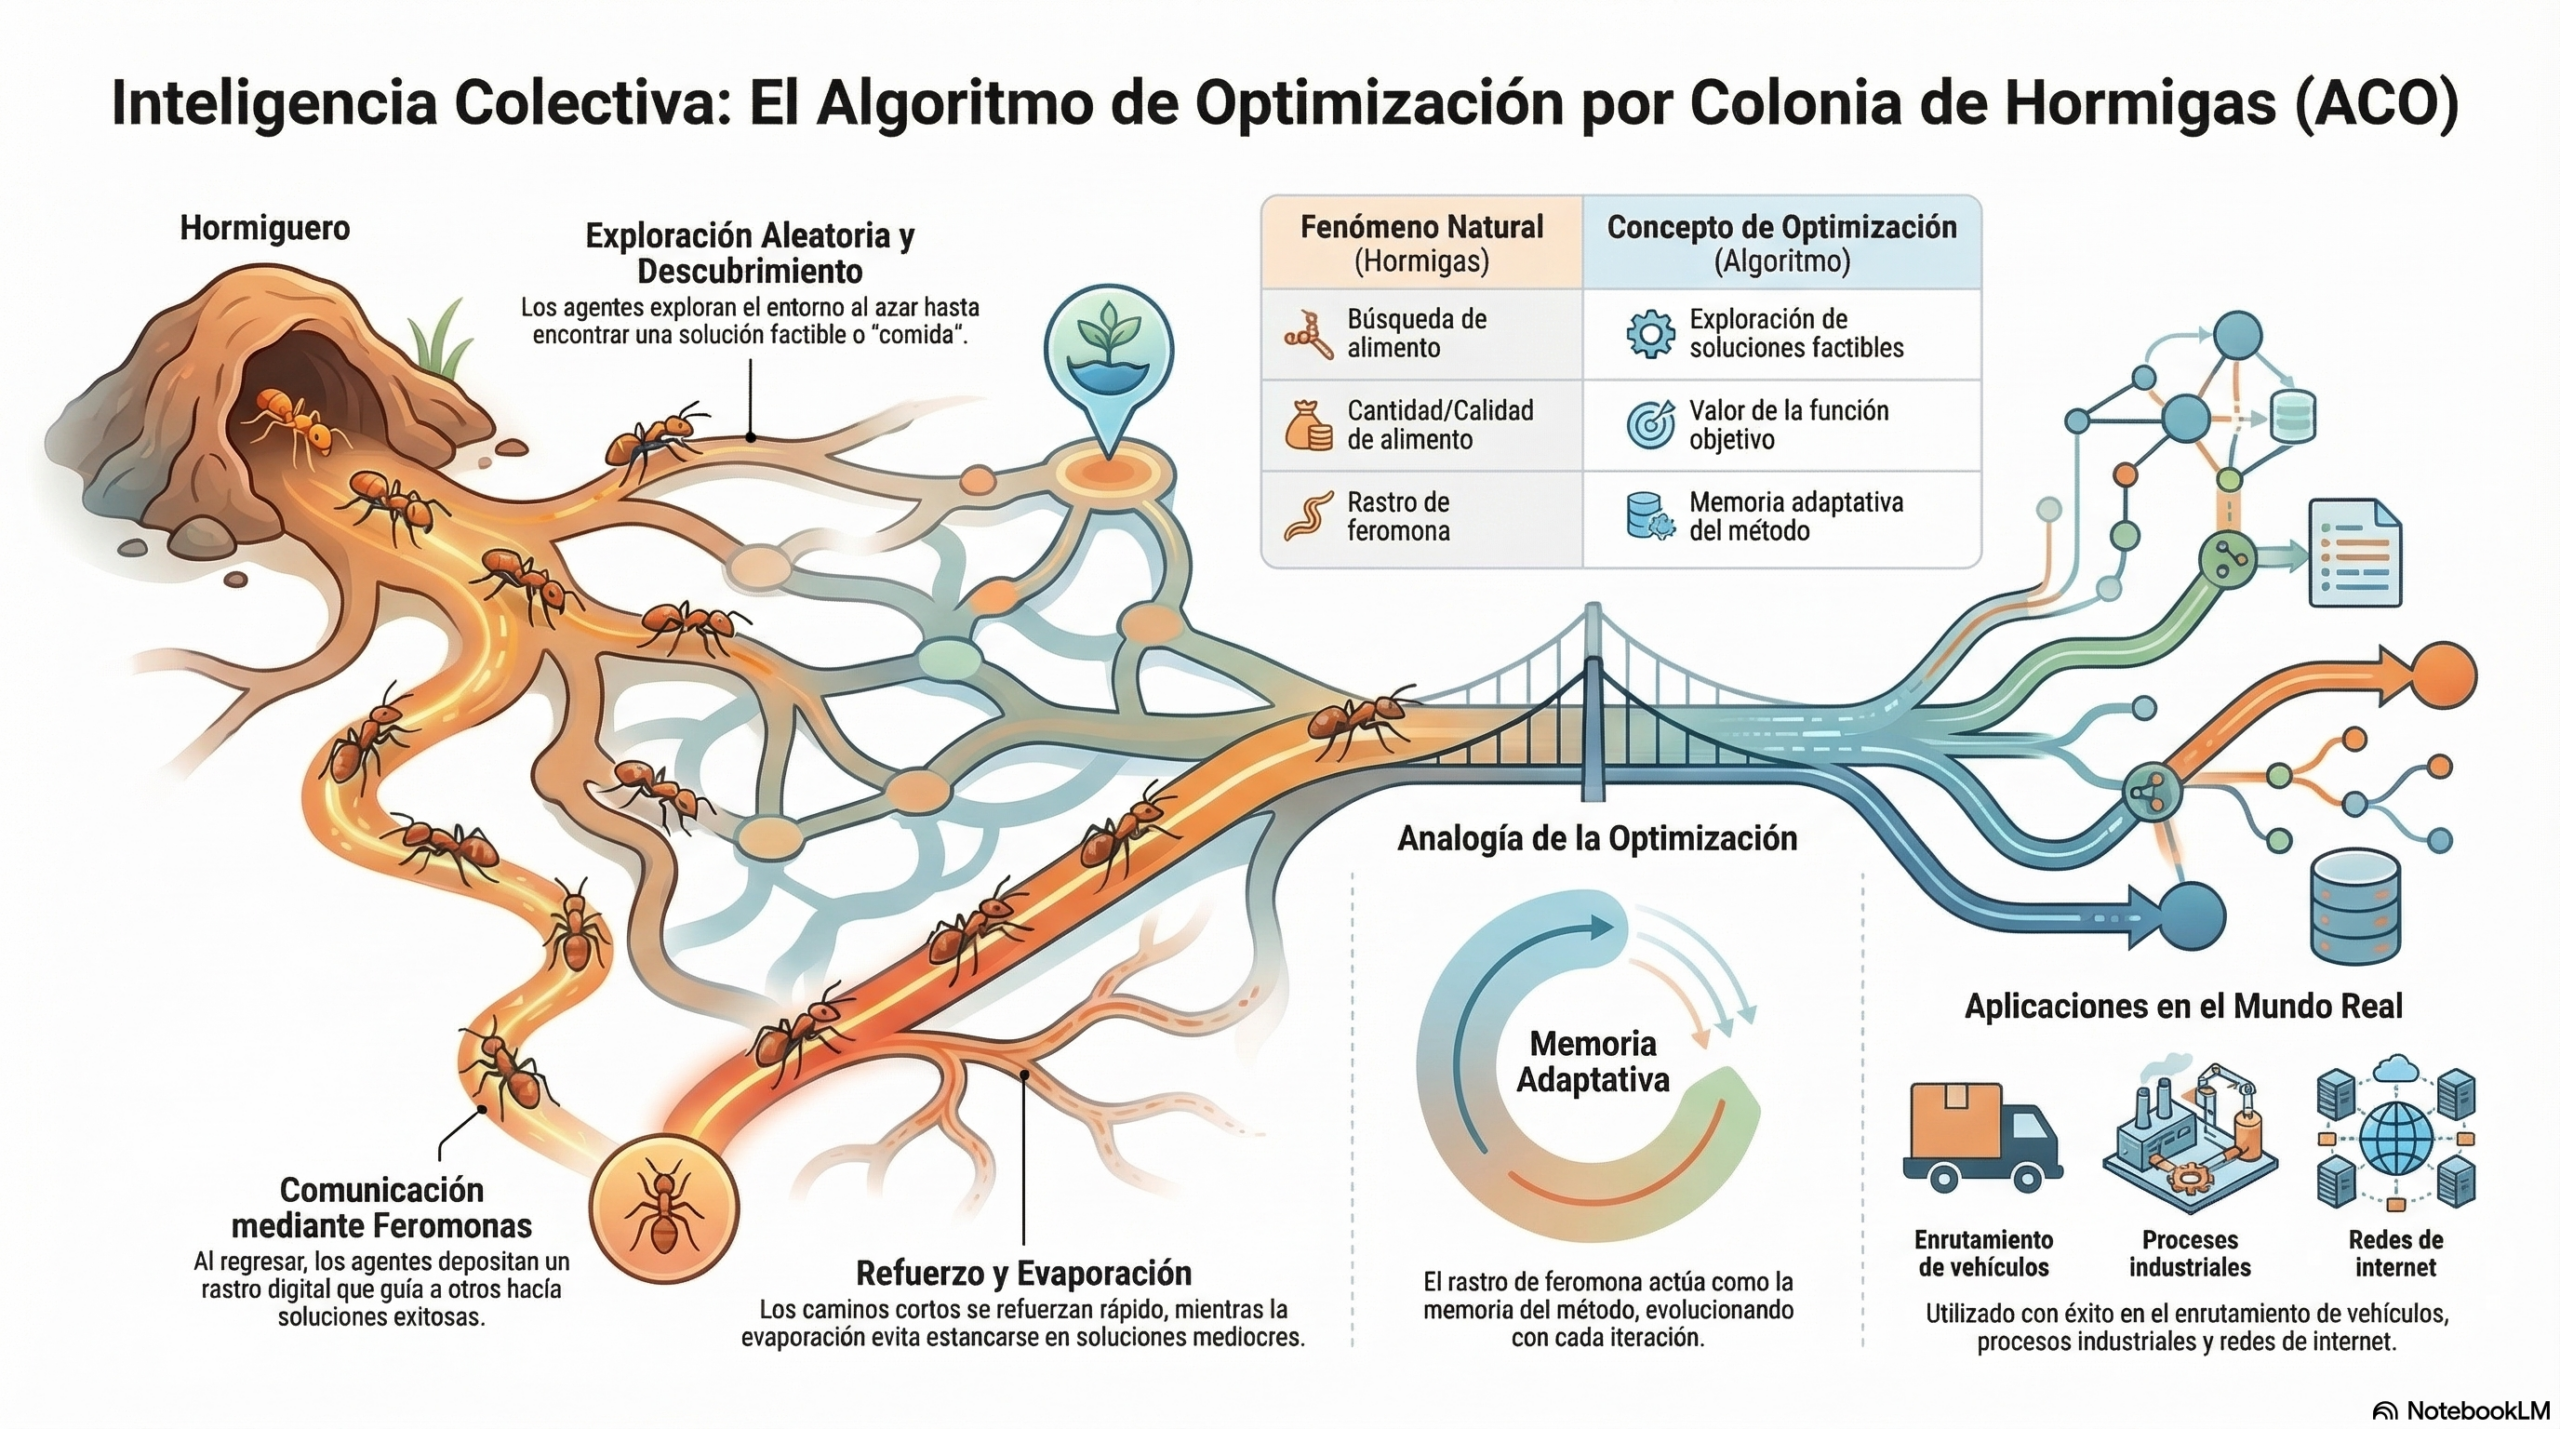
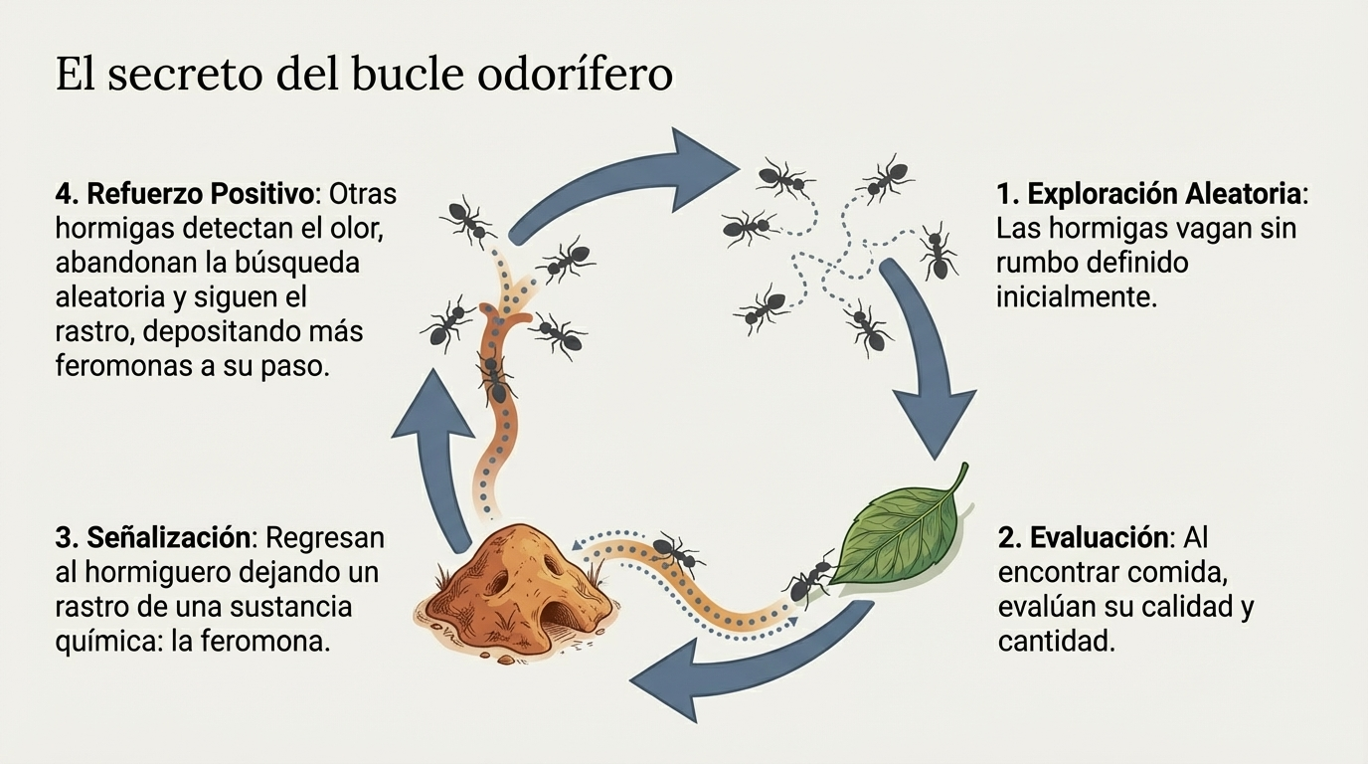
El proceso mediante el cual las hormigas optimizan sus rutas es un fascinante ciclo químico-digital. Todo comienza con una exploración aleatoria del entorno. Tan pronto como un individuo encuentra una fuente de alimento, evalúa su cantidad y calidad. Al regresar al hormiguero, deposita una sustancia química llamada feromona.

Este rastro oloroso sirve de señal para las demás hormigas. El camino más corto acaba ganando por una cuestión de frecuencia: las hormigas que viajan por la ruta más breve regresan antes y con mayor frecuencia, por lo que refuerzan ese rastro más rápido que en las rutas largas.

Sin embargo, la clave del éxito radica en la fragilidad del rastro: la feromona es dinámica y se evapora con el tiempo. Si un camino deja de usarse, la señal desaparece. Esta capacidad de «olvido» o plasticidad es vital, ya que permite que el sistema sea flexible y evita la «estagnación», impidiendo que la colonia se quede atrapada en soluciones locales, ya sean mediocres u óptimas, que ya no resultan eficientes ante un entorno cambiante.

De la biología al código: el espejo de la optimización.

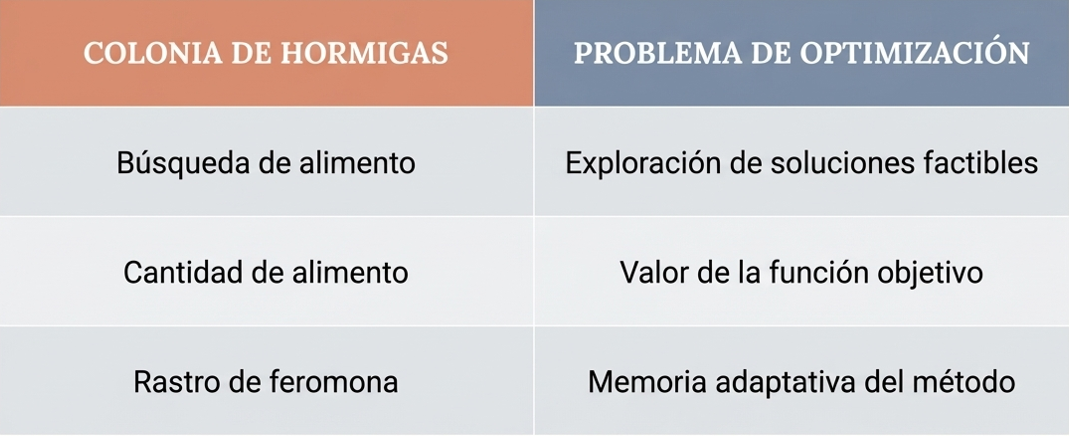
La informática ha logrado traducir estos comportamientos biológicos en algoritmos de búsqueda altamente sofisticados. Para comprender esta transición del mundo natural al ámbito del procesador, es necesario observar cómo cada elemento biológico encuentra su contraparte matemática.

Esta estructura permite a los programadores utilizar la lógica de la colonia para explorar enormes espacios de soluciones, donde encontrar la respuesta perfecta sería inviable con métodos tradicionales.

No estamos solos: el club de los optimizadores naturales.

Las hormigas no son las únicas maestras del arte de la economía de recursos. La naturaleza es un club exclusivo de optimizadores en el que la eficiencia es una ley universal de supervivencia, no una invención humana. Otros ejemplos destacados son:

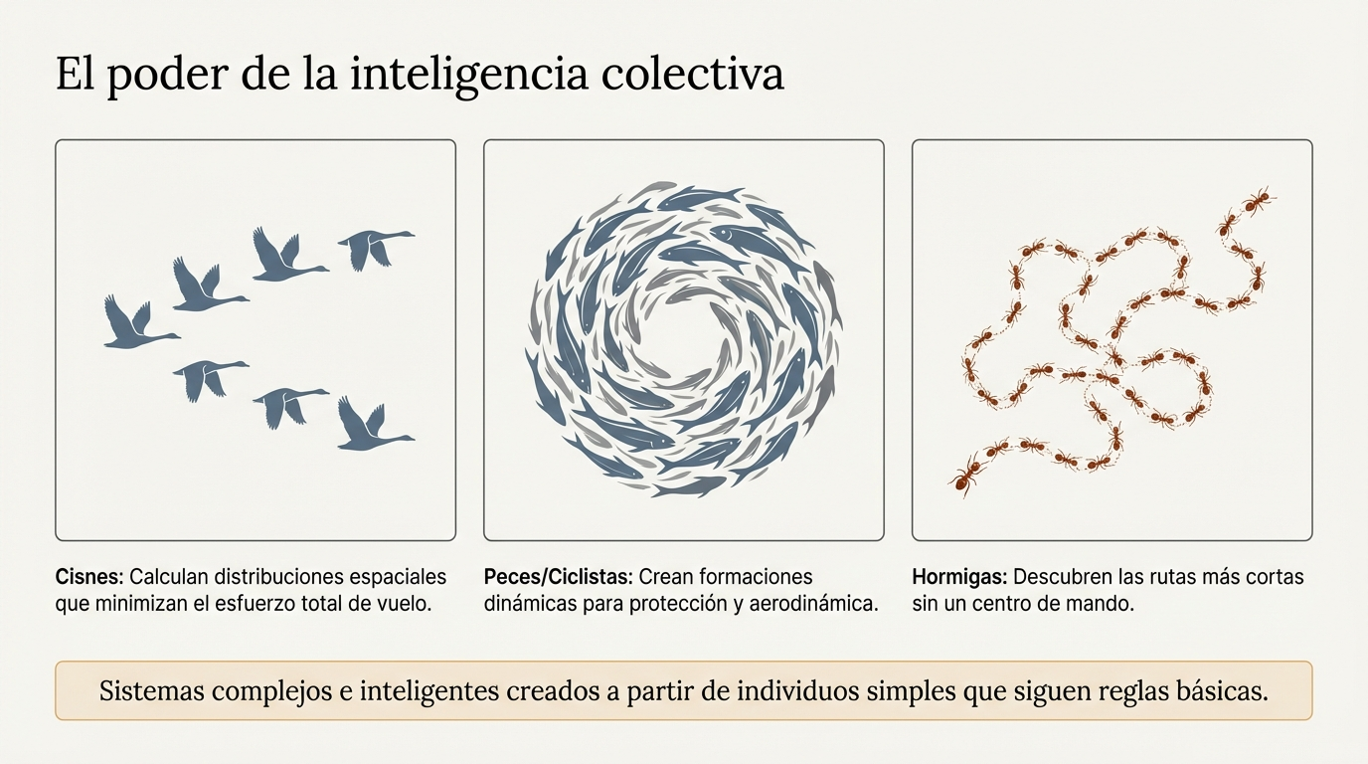
  • Los cisnes: al volar en formación de V, calculan una distribución espacial precisa para minimizar el esfuerzo total que debe realizar la bandada para desplazarse de un punto A a otro B.
  • Los depredadores y los peces: los patrones de ataque de los primeros y las formaciones de los segundos buscan la máxima efectividad con el mínimo riesgo energético.
  • Los ciclistas: apelotonándose instintivamente en una carrera para reducir la resistencia al viento, emulan estos patrones de optimización colectiva.

Conclusión: un futuro inspirado en lo pequeño.

En 1991, los investigadores Corloni, Dorigo y Maniezzo abrieron una puerta trascendental al sugerir que podíamos imitar el comportamiento de los insectos para resolver problemas de optimización combinatoria. Esa semilla científica nos permite hoy en día gestionar redes de tráfico complejas, diseñar ciudades más habitables y optimizar las cadenas logísticas globales que sustentan nuestra economía.

Si aprendiéramos a «escuchar» y a observar con mayor detenimiento los rastros y la información que fluyen en nuestro propio universo, quizá descubriríamos soluciones a problemas que hoy consideramos irresolubles.

En definitiva, nos queda una reflexión provocadora: si una hormiga no sabe que está resolviendo un algoritmo, ¿qué problemas estamos resolviendo colectivamente sin darnos cuenta?

En esta conversación puedes escuchar algunas de las ideas más interesantes sobre el tema.

Este vídeo resume bien los conceptos básicos de la optimización mediante la colonia de hormigas.

Ant_Colony_Optimization Ant_Colony_Optimization

Referencias:

COLORNI, A.; DORIGO, M.; MANIEZZO, V. (1991). Distributed optimization by ant colonies, in VARELA, F.J.; BOURGINE, P. (eds.) Proceedings of the First European Conference on Artificial Life (ECAL-91). The MIT Press: Cambrige, MA, 134-142.

MARTÍNEZ, F.; PEREA, C.; YEPES, V.; HOSPITALER, A.; GONZÁLEZ-VIDOSA, F. (2007). Optimización heurística de pilas rectangulares huecas de hormigón armado. Hormigón y Acero, 244: 67-80. ISBN: 0439-5689. (link)

MARTÍNEZ, F.J.; GONZÁLEZ-VIDOSA, F.; HOSPITALER, A.; YEPES, V. (2010). Heuristic Optimization of RC Bridge Piers with Rectangular Hollow Sections. Computers & Structures, 88: 375-386. ISSN: 0045-7949.  (link)

YEPES, V. (2003). Apuntes de optimización heurística en ingeniería. Editorial de la Universidad Politécnica de Valencia. Ref. 2003.249. Valencia, 266 pp. Depósito legal: V-2720-2003.

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.
Por qué «no existe la comida gratis» en el mundo de los algoritmos

El mito del algoritmo universal: una humillación necesaria.

Durante décadas, la comunidad científica persiguió con arrogancia el «santo grial»: el algoritmo de optimización universal. Se soñaba con una «caja negra», ya fuera basada en elegantes procesos evolutivos o en redes neuronales profundas, capaz de resolver cualquier problema, desde el diseño de un puente atirantado hasta la logística del viajante, con una eficiencia superior.

Sin embargo, esta búsqueda no solo era ambiciosa, sino que también era fundamentalmente errónea. La revelación de que no existe una inteligencia algorítmica absoluta supuso un golpe de humildad para quienes creían haber capturado la esencia del aprendizaje, cuando en realidad solo habían logrado un ajuste estadístico fortuito.

La revelación matemática: todos los algoritmos son, en promedio, iguales.

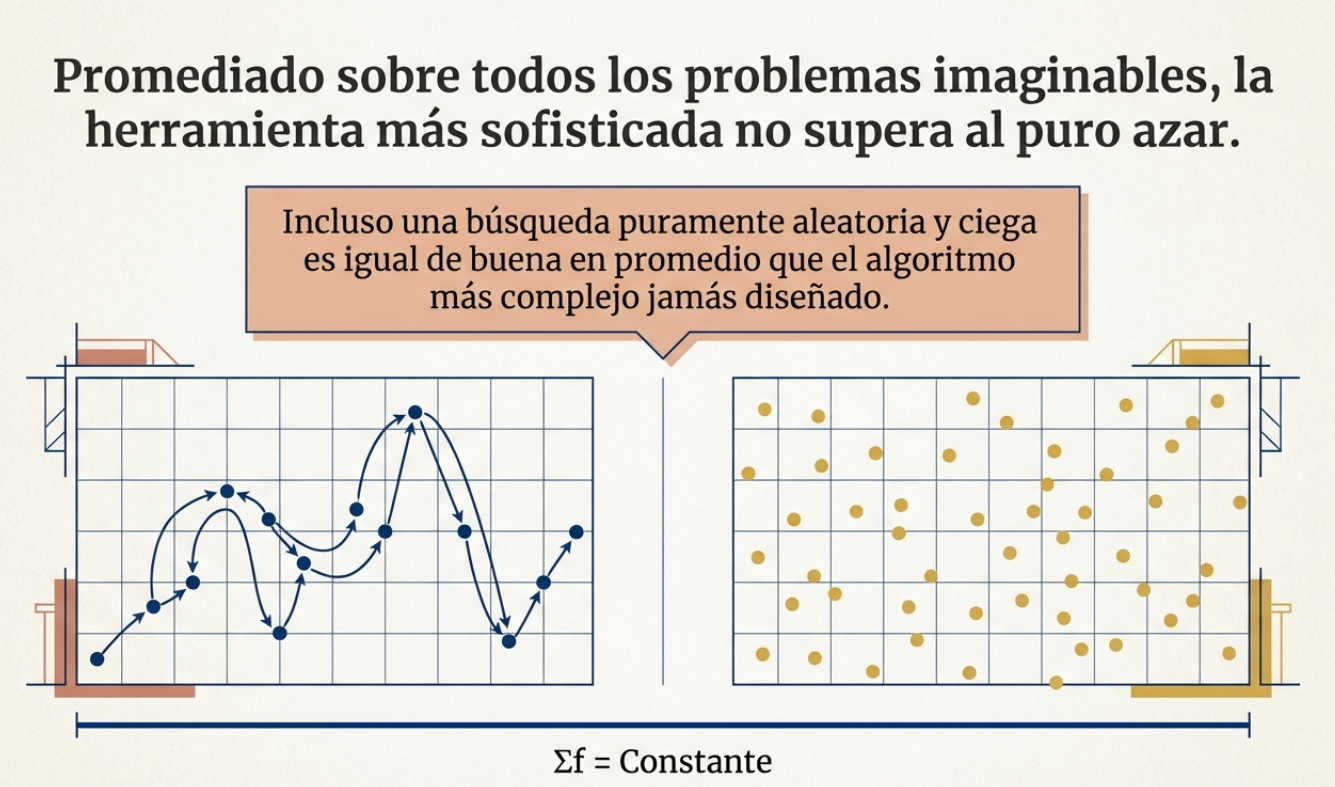
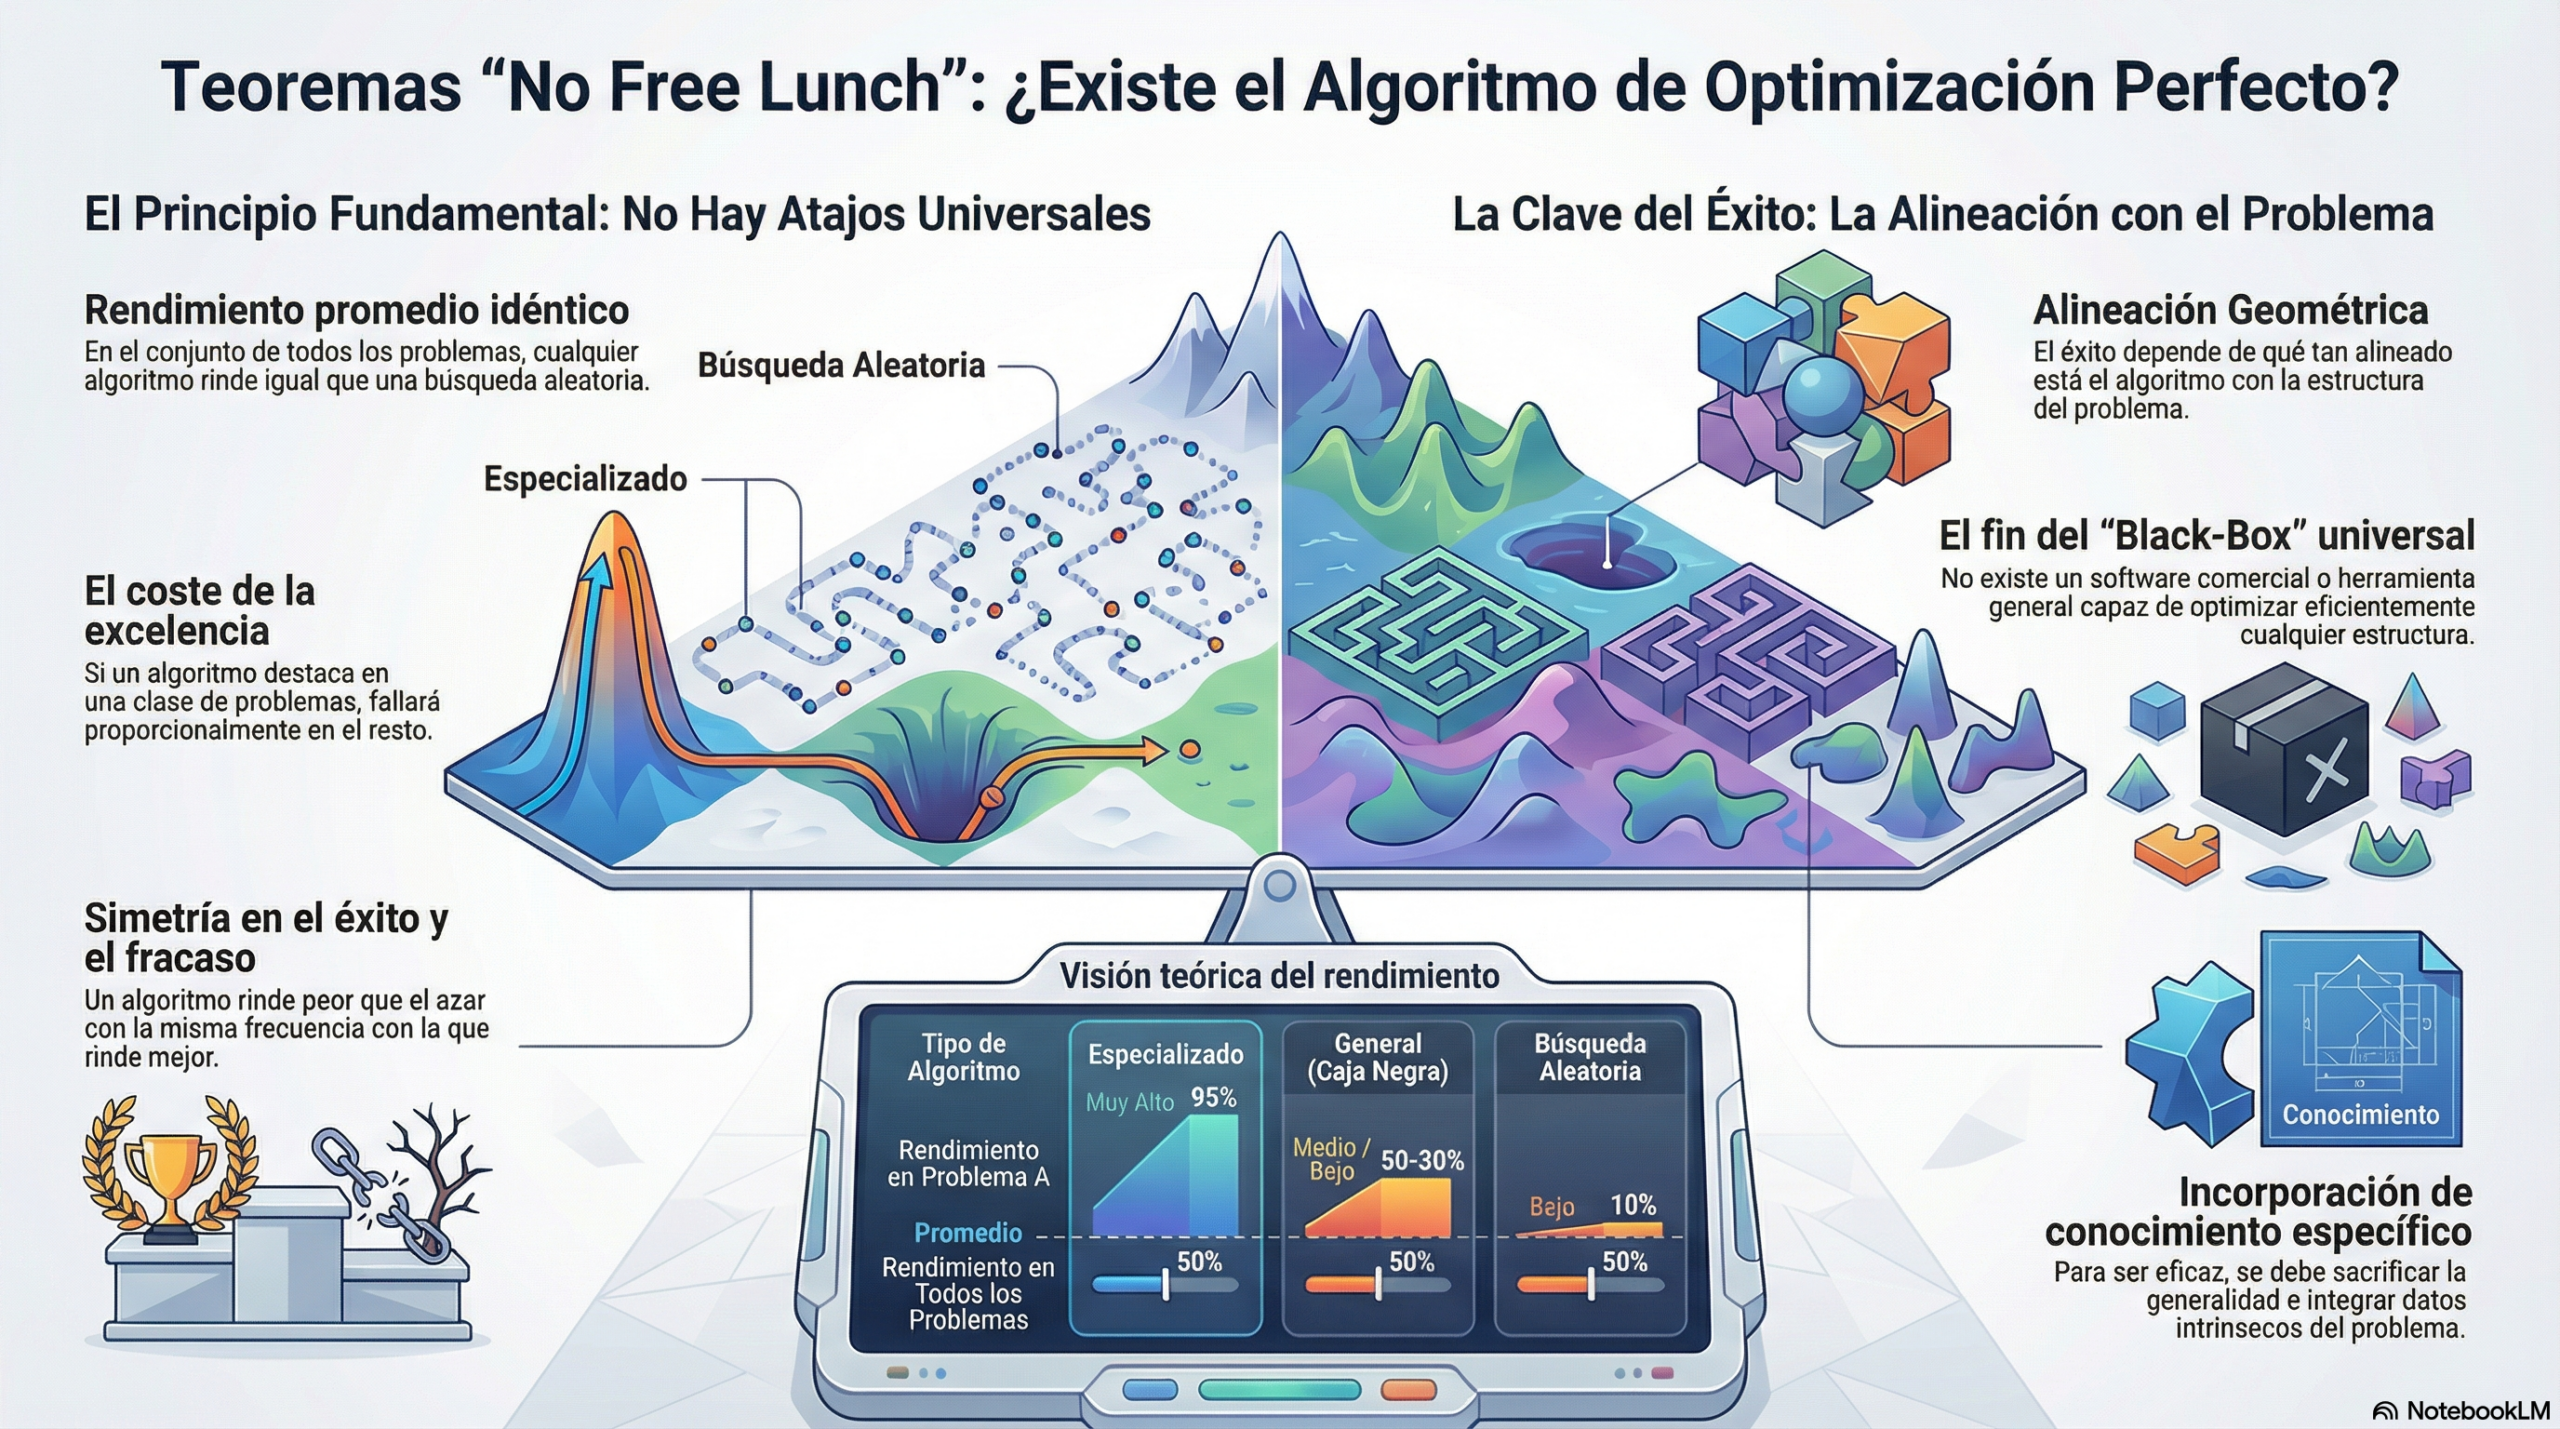
Este mito fue desmentido en 1997 por David Wolpert y William Macready. Sus teoremas «No Free Lunch» (NFL) establecieron una igualdad matemática absoluta que rompe el ego de cualquier programador: si promediamos el rendimiento sobre el conjunto de todos los problemas posibles, cualquier algoritmo sofisticado es idéntico a una búsqueda aleatoria.

Lo que un algoritmo gana en un tipo de problemas, lo paga inevitablemente con un fracaso estrepitoso en otro. No hay «comida gratis»: la superioridad de un algoritmo genético de última generación frente a un proceso de búsqueda ciega es una ilusión que solo se sostiene cuando ignoramos la inmensidad del espacio de funciones posibles.

El teorema uno nos muestra que el uso del conocimiento del dominio puede mejorar el rendimiento, a costa de la generalidad.

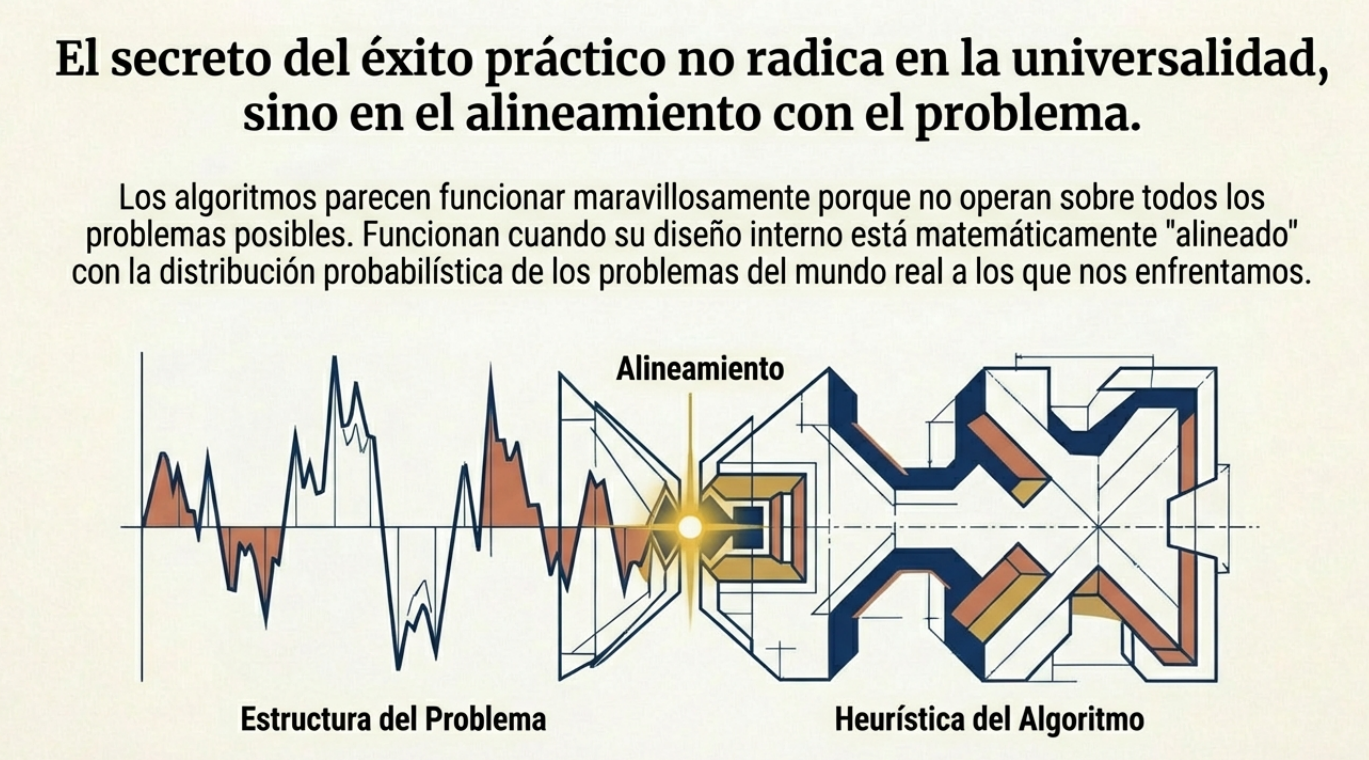
La geometría del éxito: el problema de la «alineación».

Para comprender la optimización del éxito, debemos abandonar la idea de la «fuerza bruta» y abrazar la geometría. Imagine el espacio de todas las funciones posibles como una esfera gigantesca. En este espacio, cada algoritmo es un vector v y la distribución de los problemas que deseamos resolver es otro vector p.

Estar «bien adaptado» a un problema significa que el vector del algoritmo apunta en la misma dirección que el del problema.

  • Alineación geométrica: que el vector del algoritmo apunte en la misma dirección que el del problema. El rendimiento es, en esencia, el producto interno de ambos vectores.
  • Sacrificio de la generalidad: un algoritmo «generalista» apunta hacia todas partes y, por tanto, su proyección (su éxito) en un punto concreto es nula.
  • Curvatura del conocimiento: el éxito no reside en el código, sino en cómo este «se dobla» para encajar con la estructura lógica y física del problema.

Los investigadores del problema del viajante no han creado algoritmos «mejores» en términos absolutos, sino que han esculpido herramientas íntimamente alineadas con la geometría específica de las rutas y las distancias.

El golpe al ego: el algoritmo aleatorio como juez de paz.

Los teoremas 5 y 6 de Wolpert y Macready introducen un estándar de rigor que actúa como un «mínimo ético» para la ciencia. Si un algoritmo no consigue que el coste disminuya más rápido que con una búsqueda aleatoria, el investigador habrá fracasado.

Esta métrica es el antídoto contra el fraude intelectual del ajuste fino o manual. Muchos de los éxitos que se describen en la literatura no son más que el resultado de forzar un algoritmo a un puñado de problemas específicos sin superar el umbral de una búsqueda ciega. Superar al «juez de paz» aleatorio es la única prueba de que el algoritmo ha logrado capturar alguna estructura real del problema.

Consecuencias prácticas: el fin del experto generalista.

En ingeniería civil, las implicaciones del NFL son tajantes. No existen programas comerciales que puedan optimizar cualquier estructura de forma indiscriminada. Las herramientas generales (como las toolboxes estándar de Matlab) suelen ser ineficaces porque carecen del «conocimiento del hormigón».

Esta realidad ha provocado una «carrera armamentística» hacia la especialización.

  • Hibridación: La respuesta de la ingeniería moderna consiste en combinar metaheurísticas con técnicas de deep learning y redes neuronales para «aprender» la estructura del dominio.
  • Alineación estructural: un matemático brillante fracasará al optimizar un puente atirantado si no comprende la resistencia de los materiales. No se trata de falta de cálculo, sino de que su algoritmo no está alineado con la «curvatura» física del problema. El conocimiento experto es lo que permite al algoritmo encontrar el camino en un espacio de búsqueda que, de otro modo, sería un desierto uniforme.

El dilema del observador: la ceguera del éxito pasado.

Incluso cuando un algoritmo ha funcionado bien hasta ahora, el teorema 10 (sección VII) nos da un jarro de agua fría: observar el rendimiento pasado no garantiza el éxito futuro sin un conocimiento adicional sobre la función de coste. Sin conocer la estructura, no vemos el siguiente paso.

En este estado de «oscuridad estructural», un procedimiento de elección «irracional» (cambiar un algoritmo que ha funcionado bien por otro que ha funcionado mal) es tan válido como uno «racional». Sin suposiciones sobre la relación entre el algoritmo y la función, el comportamiento pasado es un predictor pobre. La lógica solo surge cuando el observador aporta información que no está presente en los datos.

Conclusión: hacia una optimización consciente.

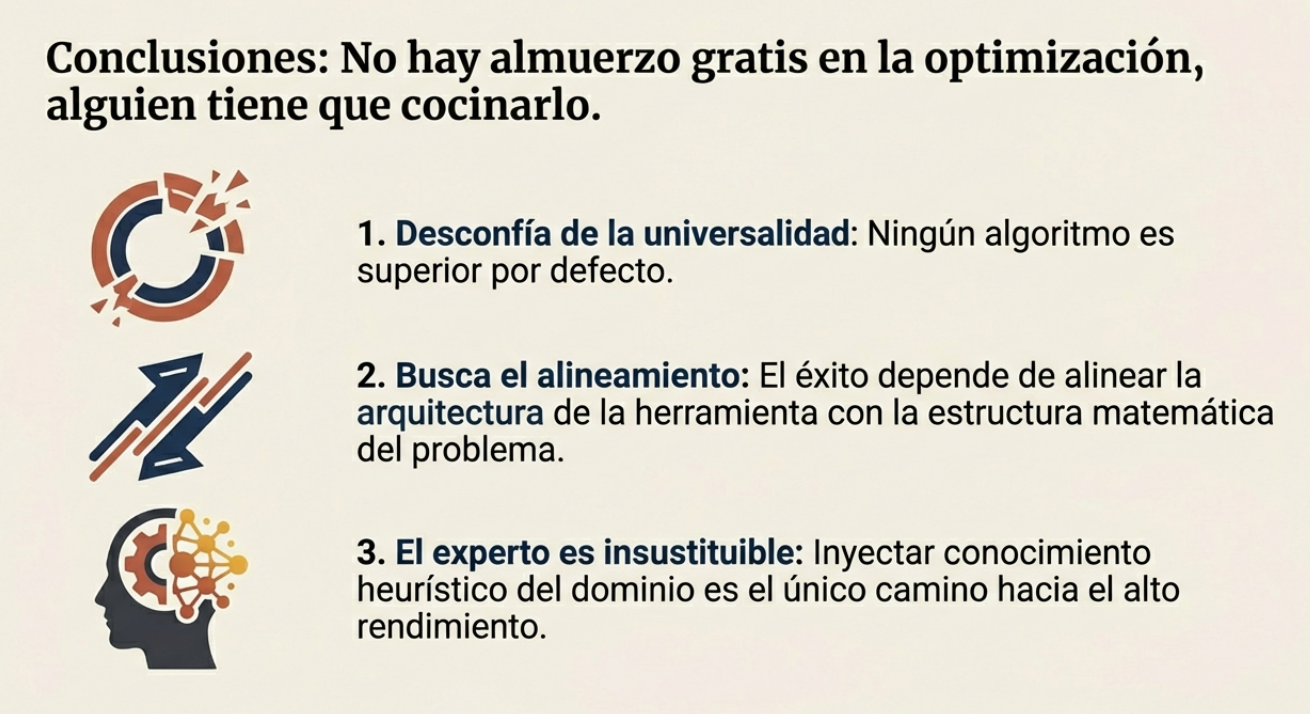
Debemos aceptar una verdad incómoda: nuestra inteligencia artificial es un reflejo limitado del conocimiento que somos capaces de codificar en ella. La ciencia de la optimización ya no debe buscar el «algoritmo perfecto», sino métodos más profundos para transferir el conocimiento del dominio al proceso de búsqueda.

Si el rendimiento de nuestras máquinas depende por completo de lo que ya sabemos sobre el mundo, ¿no será que la «inteligencia artificial general» es un mito termodinámico, similar a la máquina de movimiento perpetuo? Quizás el mayor descubrimiento de Wolpert y Macready no fue matemático, sino filosófico: la inteligencia no es más que el conocimiento del problema disfrazado de código.

En esta conversación puedes escuchar las ideas más interesantes sobre este tema.

Este vídeo resume bien los conceptos más importantes tratados.

The_Universal_Algorithm_Myth

Referencias:

GARCÍA, J.; YEPES, V.; MARTÍ, J.V. (2020a). A hybrid k-means cuckoo search algorithm applied to the counterfort retaining walls problem. Mathematics,  8(4), 555.

MARTÍNEZ-MUÑOZ, D.; GARCÍA, J.; MARTÍ, J.V.; YEPES, V. (2022). Optimal design of steel-concrete composite bridge based on a transfer function discrete swarm intelligence algorithm. Structural and Multidisciplinary Optimization, 65:312. DOI:10.1007/s00158-022-03393-9

NEGRÍN, I.; CHAGOYÉN, E.; KRIPKA, M.; YEPES, V. (2025). An integrated framework for Optimization-based Robust Design to Progressive Collapse of RC skeleton buildings incorporating Soil-Structure Interaction effects. Innovative Infrastructure Solutions, 10:446. DOI:10.1007/s41062-025-02243-z

WOLPERT, D.H.; MACREADY, W.G. (1997). No Free Lunch Theorems for Optimization. IEEE Transactions on Evolutionary Computation, 1(1):67-82.

YEPES-BELLVER, L.; BRUN-IZQUIERDO, A.; ALCALÁ, J.; YEPES, V. (2025). Surrogate-assisted cost optimization for post-tensioned concrete slab bridges. Infrastructures, 10(2): 43. DOI:10.3390/infrastructures10020043.

A continuación os dejo el artículo original «No Free Lunch Theorems for Optimization». Se ha convertido en un clásico de optimización heurística.

Pincha aquí para descargar

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.
La inteligencia de la naturaleza: cinco lecciones de los algoritmos genéticos.

Optimizar una estructura de hormigón no es solo una cuestión de cálculo, sino una batalla contra la entropía. Además, en la búsqueda de la combinación precisa entre la cantidad de acero y la resistencia del hormigón, el ingeniero se enfrenta a un océano de variables en el que la solución «perfecta» suele estar oculta bajo capas de complejidad técnica. Por tanto, el proceso exige no solo rigor analítico, sino también una comprensión profunda de cómo interactúan todos los factores que condicionan el diseño estructural.

Ante este desafío, la ingeniería moderna ha dejado de lado las calculadoras para observar el mecanismo de diseño más refinado de la historia: la selección natural.

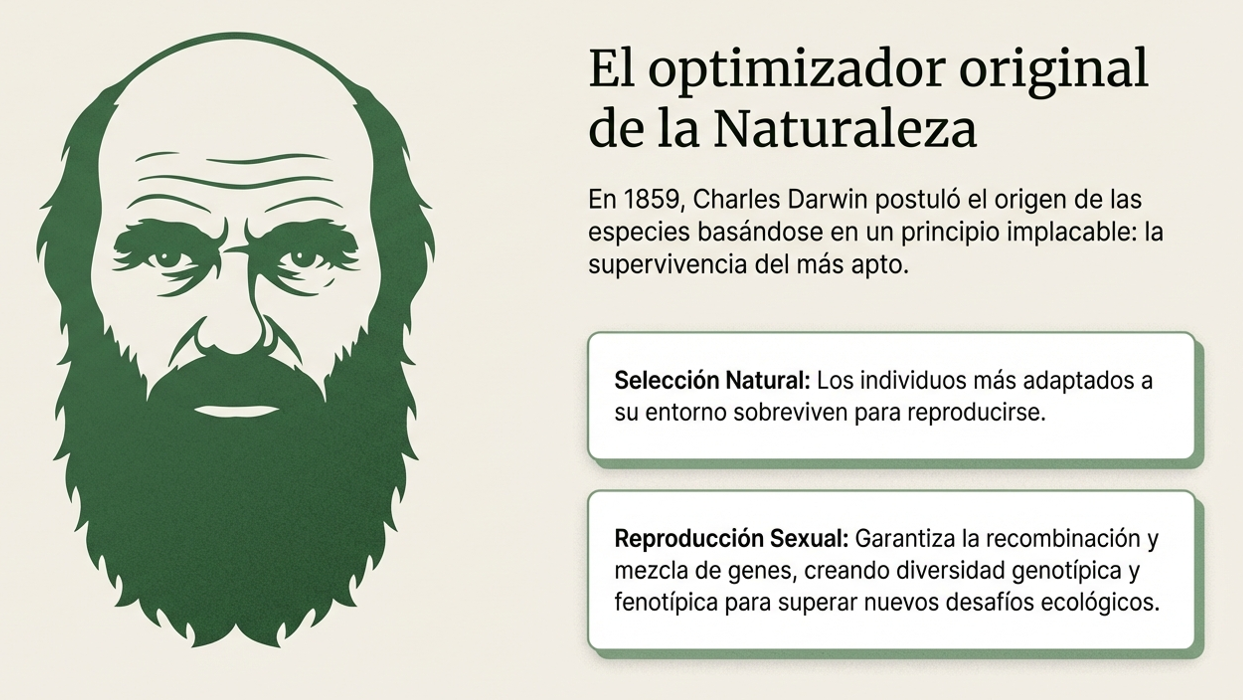
Hace más de un siglo, Charles Darwin descubrió que la supervivencia es el resultado de un proceso en el que sobreviven los más aptos y transmiten sus rasgos. Hoy en día, aplicamos este rigor biológico a los algoritmos genéticos. Estos sistemas no solo resuelven problemas, sino que también imitan la vida misma para encontrar respuestas con una elegancia estructural que antes considerábamos inalcanzable.

Lección 1: La evolución no ocurre en el individuo, sino en su código.

Una de las distinciones más profundas de la computación evolutiva es que la mejora de un sistema no se logra manipulando el objeto final (el puente o la viga), sino su receta original. Para que un algoritmo sea verdaderamente evolutivo, debe comprender que el éxito se forja en las estructuras subyacentes, tal y como lo definió Davis en 1991:

«La evolución opera en los cromosomas, en lugar de en los individuos a los que representan».

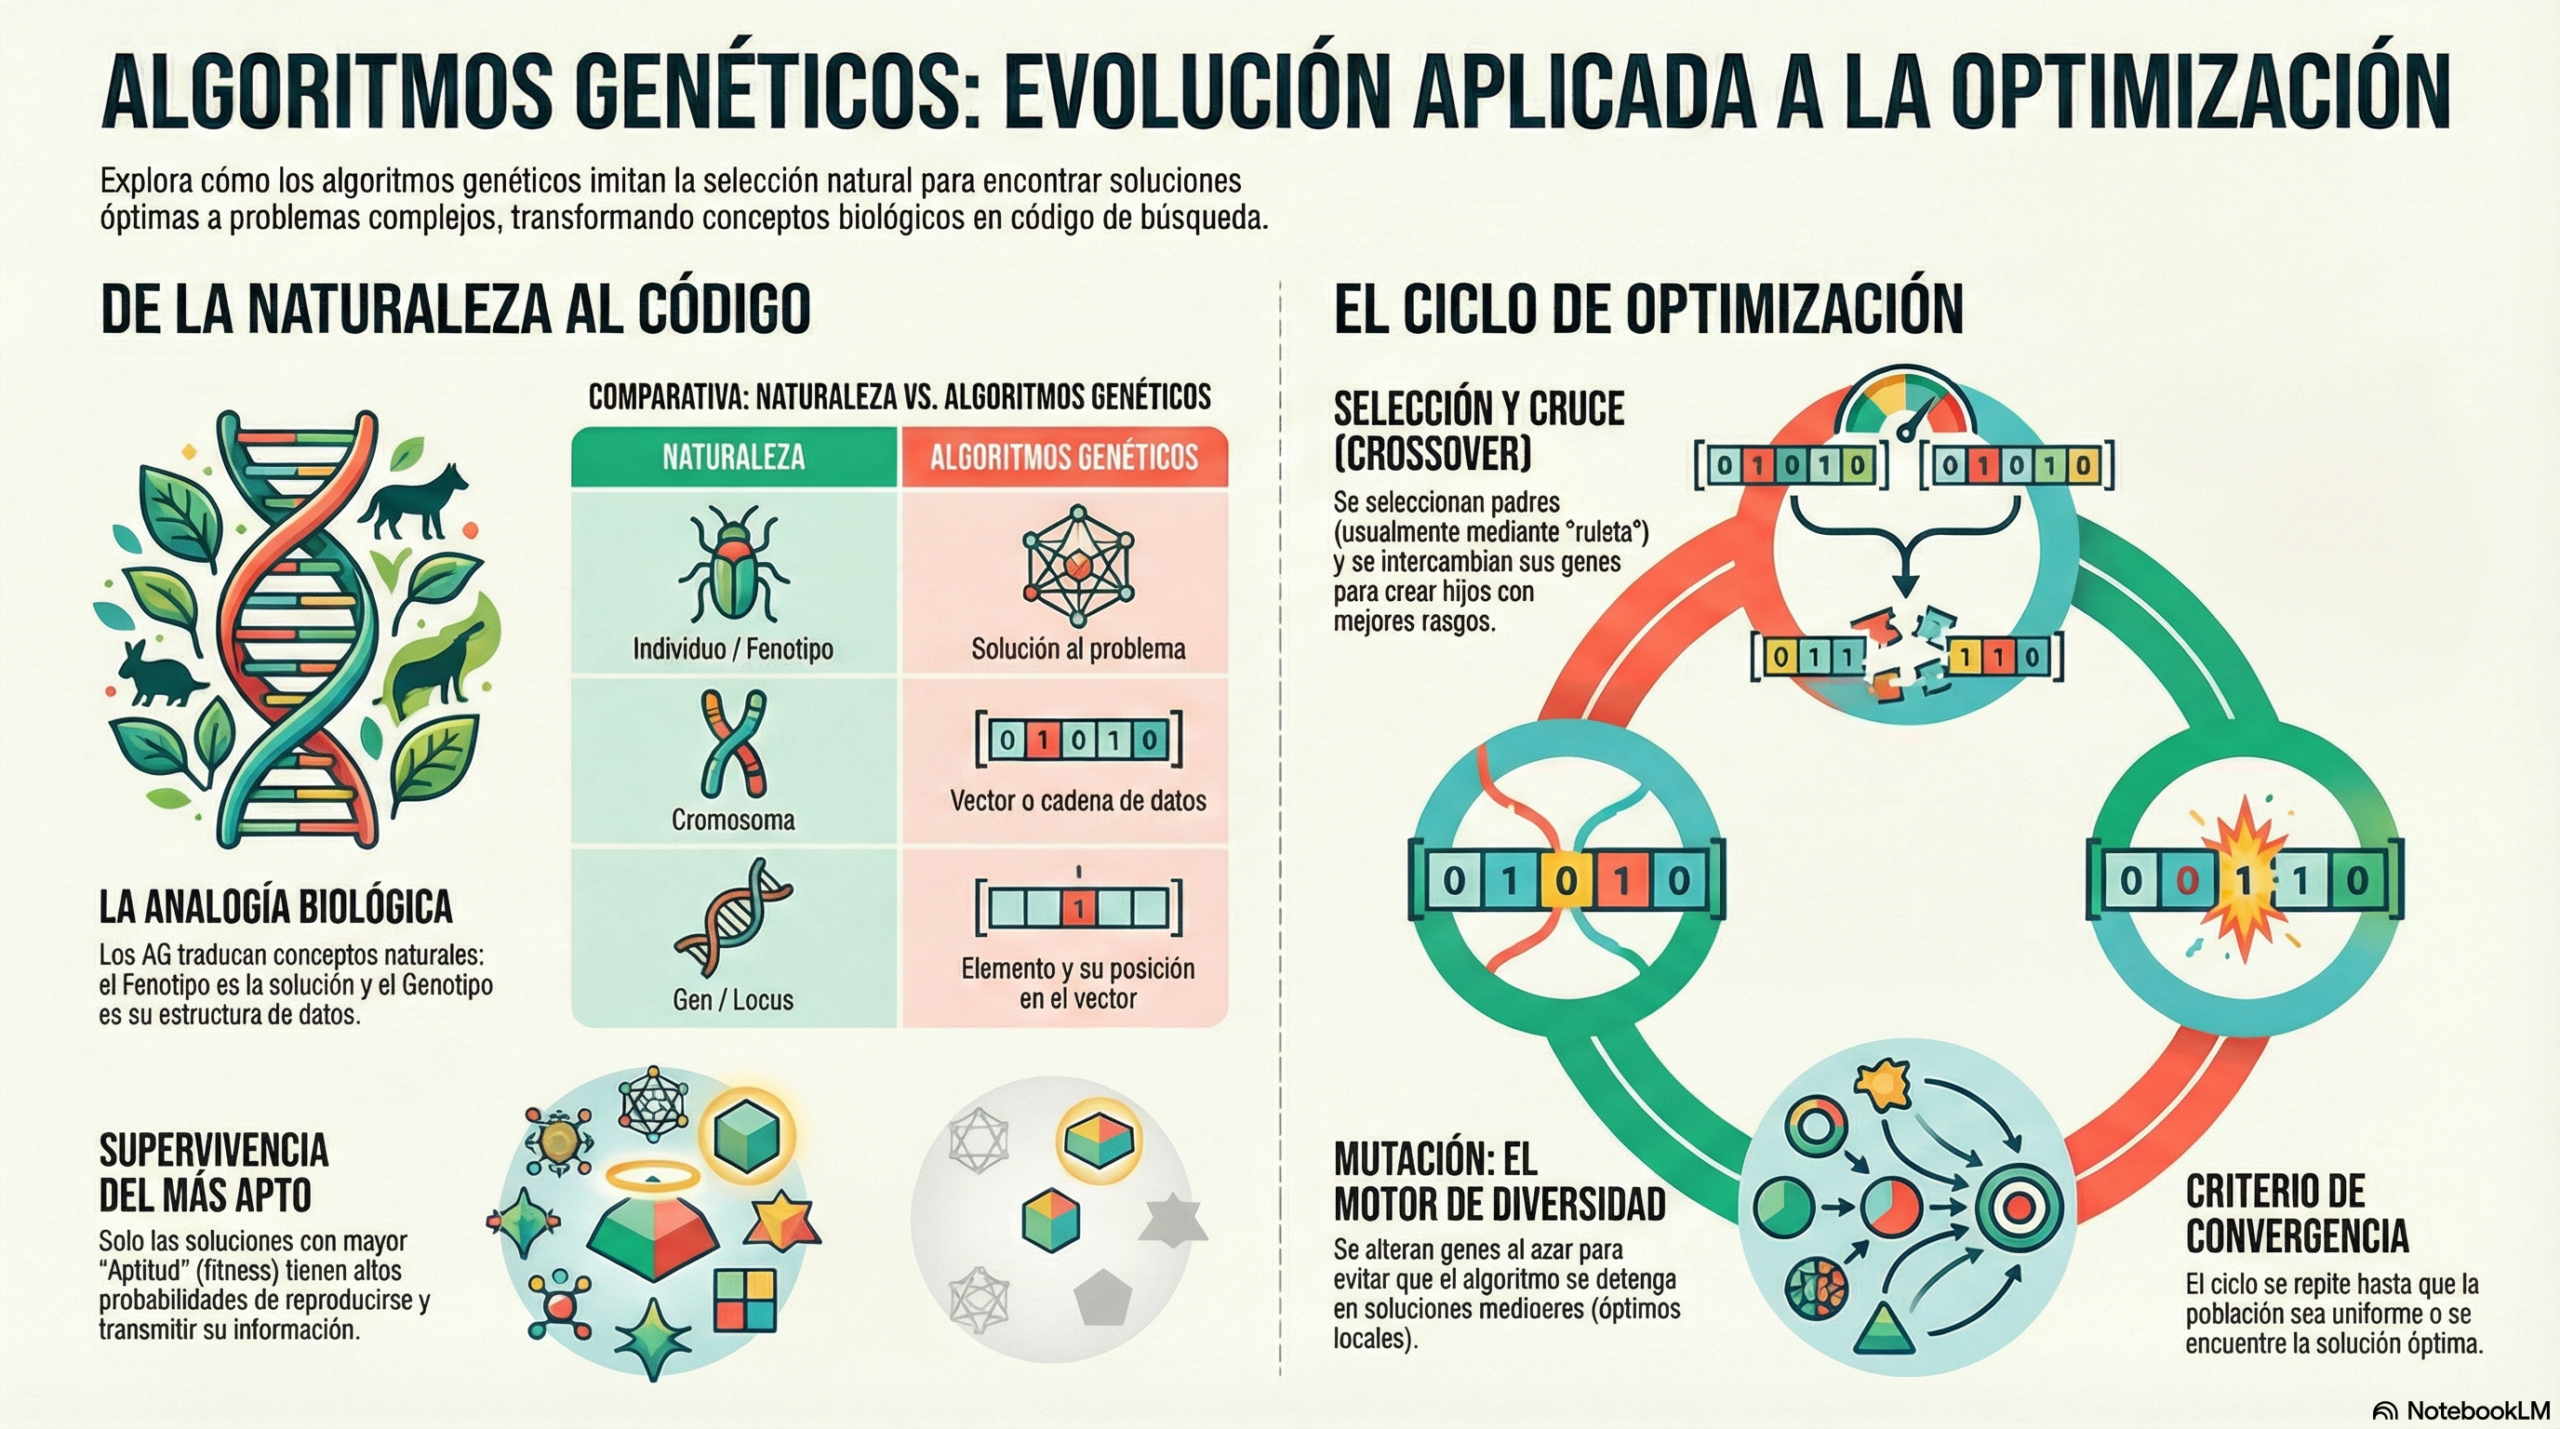
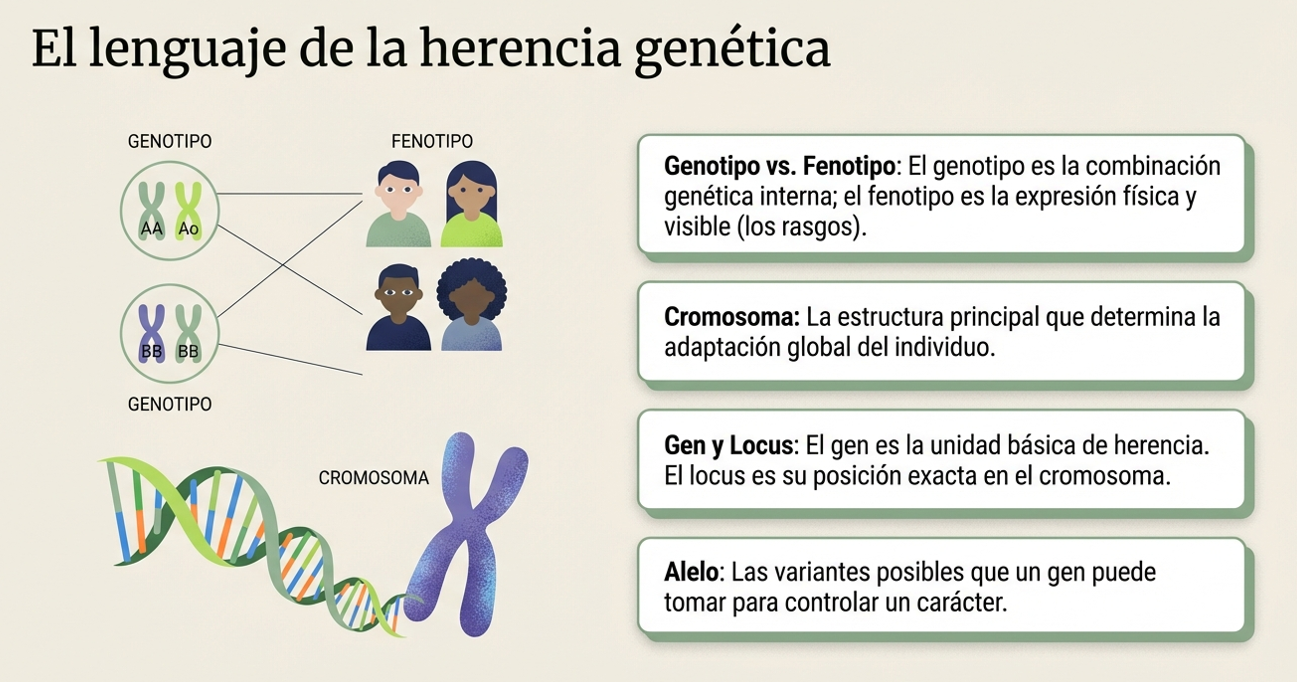
Este enfoque resulta fascinante por lo contraintuitivo que es: para optimizar una estructura física (el fenotipo), manipulamos un vector binario o un string (el genotipo). Al trabajar con la representación abstracta, permitimos que el código explore cambios profundos sin las limitaciones del diseño inmediato, entendiendo que el cromosoma es el verdadero custodio de la adaptación global.

Lección 2: El diccionario biológico del programador.

Para resolver problemas de ingeniería como si fueran organismos vivos, debemos traducir la realidad física a un lenguaje genético preciso. Ver una solución técnica como un «ser» con ADN transforma radicalmente nuestra metodología de resolución.

  • Fenotipo: la solución final y detectable; la expresión física de la interacción genética.
  • Genotipo: la estructura o plan maestro a partir del cual se construye el organismo.
  • Cromosoma: vector o cadena de datos que almacena información.
  • Gen: Cada elemento del vector (un «vagón de tren» en la cadena de datos).
  • Alelo: el valor específico que adopta ese elemento (el bit o dato concreto).
  • Locus: posición exacta del gen, fundamental porque controla un carácter específico de la solución.
  • Aptitud (fitness): función objetivo que mide la capacidad de la solución para sobrevivir en su entorno técnico.

Lección 3: La «ruleta» de la supervivencia y la selección natural.

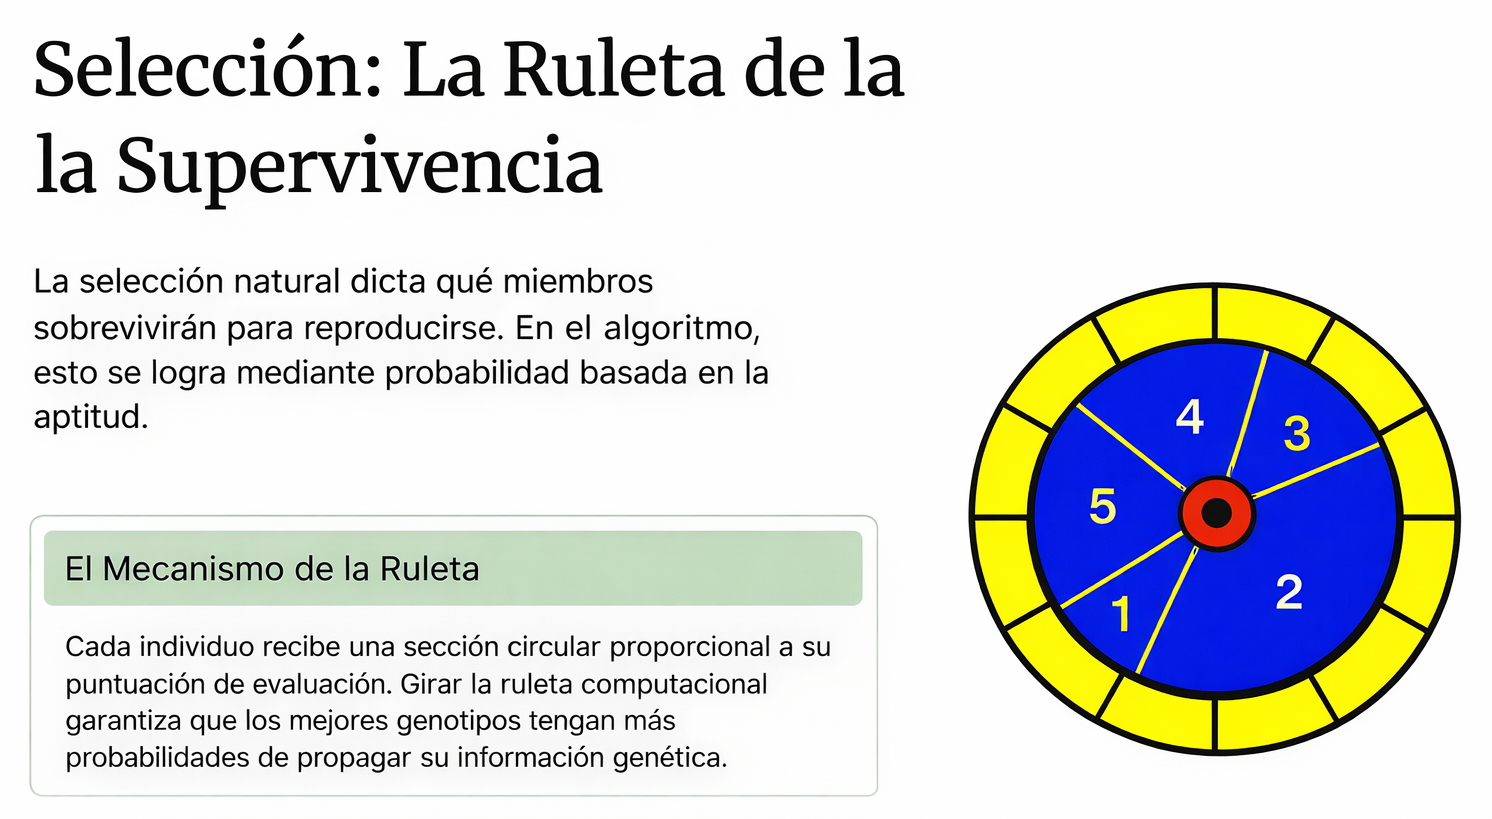
La selección natural no funciona como un sorteo, aunque tampoco actúa como una sentencia absoluta. Este principio se traslada al código mediante el método de la ruleta. En dicho procedimiento, cada solución se representa por un segmento circular cuya superficie es proporcional a su nivel de aptitud.

Esta «justicia algorítmica» garantiza que los mejores tengan mayores probabilidades de dejar descendencia. Sin embargo, no garantiza el monopolio de la reproducción, ya que los individuos menos aptos mantienen una pequeña probabilidad de transmitir sus genes. Este «caos controlado» es vital, ya que garantiza la diversidad estructural y evita que el algoritmo se estanque en óptimos locales, es decir, soluciones que parecen buenas solo porque el sistema ha perdido la capacidad de mirar más allá de lo inmediato.

Lección 4: Cruzamiento y mutación. El «sexo» de los datos.

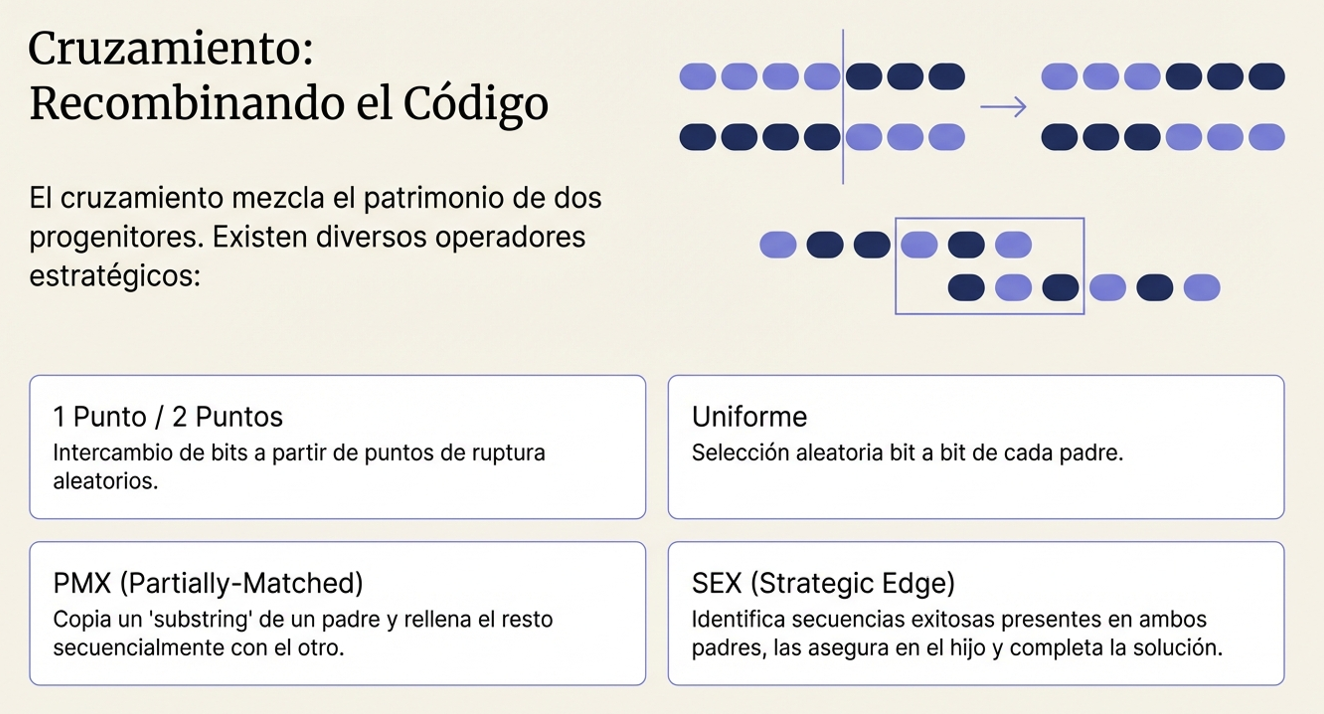
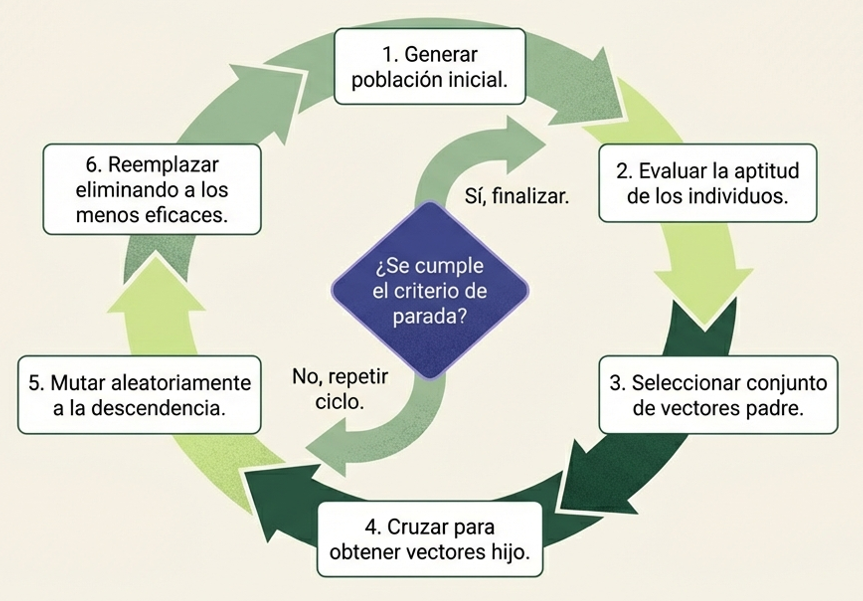
La evolución exige novedad. Si nos limitáramos a clonar a los mejores, el progreso se detendría. Por ello, los algoritmos utilizan la recombinación o cruzamiento, mediante el cual dos progenitores intercambian información para crear descendientes con rasgos mixtos. Se destacan operadores sofisticados como el PMX (Partially-Matched Crossover), que copia un fragmento del código manteniendo las posiciones y rellena el resto con valores no utilizados, y el SEX (Strategic Edge Crossover), que busca identificar y preservar secuencias presentes en ambos progenitores.

Pero la mezcla no es suficiente. Es necesaria la mutación para introducir variaciones que no existían en la población original.

«Mutación: modificación espontánea de la información genética».

La mutación actúa como un factor de diversificación radical. Ya sea reemplazando un bit o recombinando elementos al azar sin considerar su aptitud inicial, este mecanismo introduce el «ruido» necesario para sacudir el sistema y permitirle dar el salto a fronteras de eficiencia completamente nuevas.

Lección 5: La memoria es un lastre para la evolución.

Siguiendo la lógica de Holland, uno de los conceptos más disruptivos de la evolución es su capacidad para vivir en el presente absoluto. A diferencia de otros sistemas de optimización que arrastran sesgos históricos, la evolución es un proceso sin memoria en el sentido estricto, ya que es una eficiencia de estado.

Durante la formación de nuevos cromosomas, el algoritmo solo tiene en cuenta la información del periodo inmediatamente anterior. Este enfoque «radical» permite que el sistema converja hacia la excelencia técnica basándose exclusivamente en la eficacia actual de los rasgos, sin verse frenado por configuraciones que fueron útiles en el pasado, pero ya no sirven para afrontar los desafíos del presente. Se podría decir que es una búsqueda de la perfección despojada de prejuicios históricos.

Los algoritmos genéticos demuestran que la naturaleza ya había resuelto los problemas de optimización más difíciles hace millones de años. Al adoptar estas leyes biológicas, la ingeniería no solo encuentra mejores soluciones para sus puentes y edificios, sino que lo hace con una elegancia que solo la evolución puede dictar.

Si principios tan elementales como la herencia y la mutación pueden dar lugar a estructuras de hormigón de una eficiencia asombrosa, ¿qué otros procesos naturales esconden hoy la clave para el próximo gran avance en la inteligencia de nuestro software?

En esta conversación puedes escuchar las ideas más interesantes sobre este tema.

Este vídeo resume bien los conceptos básicos de los algoritmos genéticos.

Aquí tenéis un vídeo en el que explico este algoritmo. Espero que os interese.

Genetic_Algorithms

Referencias:

DENNETT, D.C. (1999). La peligrosa idea de Darwin. Galaxia Gutenberg. Círculo de Lectores, Barcelona.

HOLLAND, J.H. (1975). Adaptation in natural and artificial systems. University of Michigan Press, Ann Arbor.

MARTÍNEZ, F.J.; GONZÁLEZ-VIDOSA, F.; HOSPITALER, A.; YEPES, V. (2010). Heuristic Optimization of RC Bridge Piers with Rectangular Hollow Sections. Computers & Structures, 88: 375-386. ISSN: 0045-7949.  (link)

MEDINA, J.R.; YEPES, V. (2003). Optimization of touristic distribution networks using genetic algorithms. Statistics and Operations Research Transactions, 27(1): 95-112.  ISSN: 1696-2281.  (pdf)

PONZ-TIENDA, J.L.; YEPES, V.; PELLICER, E.; MORENO-FLORES, J. (2013). The resource leveling problem with multiple resources using an adaptive genetic algorithm. Automation in Construction, 29(1):161-172. DOI:http://dx.doi.org/10.1016/j.autcon.2012.10.003. (link)

YEPES, V. (2003). Apuntes de optimización heurística en ingeniería. Editorial de la Universidad Politécnica de Valencia. Ref. 2003.249. Valencia, 266 pp. Depósito legal: V-2720-2003.

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.
Algoritmia, heurísticas y optimización computacional

En el corazón de nuestra civilización digital late un motor invisible que solemos dar por sentado. Lo que en el siglo IX nació como una serie de reglas rígidas para el cálculo algebraico —el legado de Al-Juarismi— ha evolucionado hasta convertirse en el concepto moderno de algoritmo: una sofisticada «receta» diseñada para manipular información mediante operaciones elementales. En la actualidad, los algoritmos no son solo curiosidades matemáticas, sino la infraestructura lógica que decide desde la ruta de un camión de reparto hasta la resistencia de un viaducto de hormigón. Sin embargo, ¿comprendemos realmente las leyes que rigen su eficiencia o somos ciegos ante las reglas que separan lo posible de lo imposible?

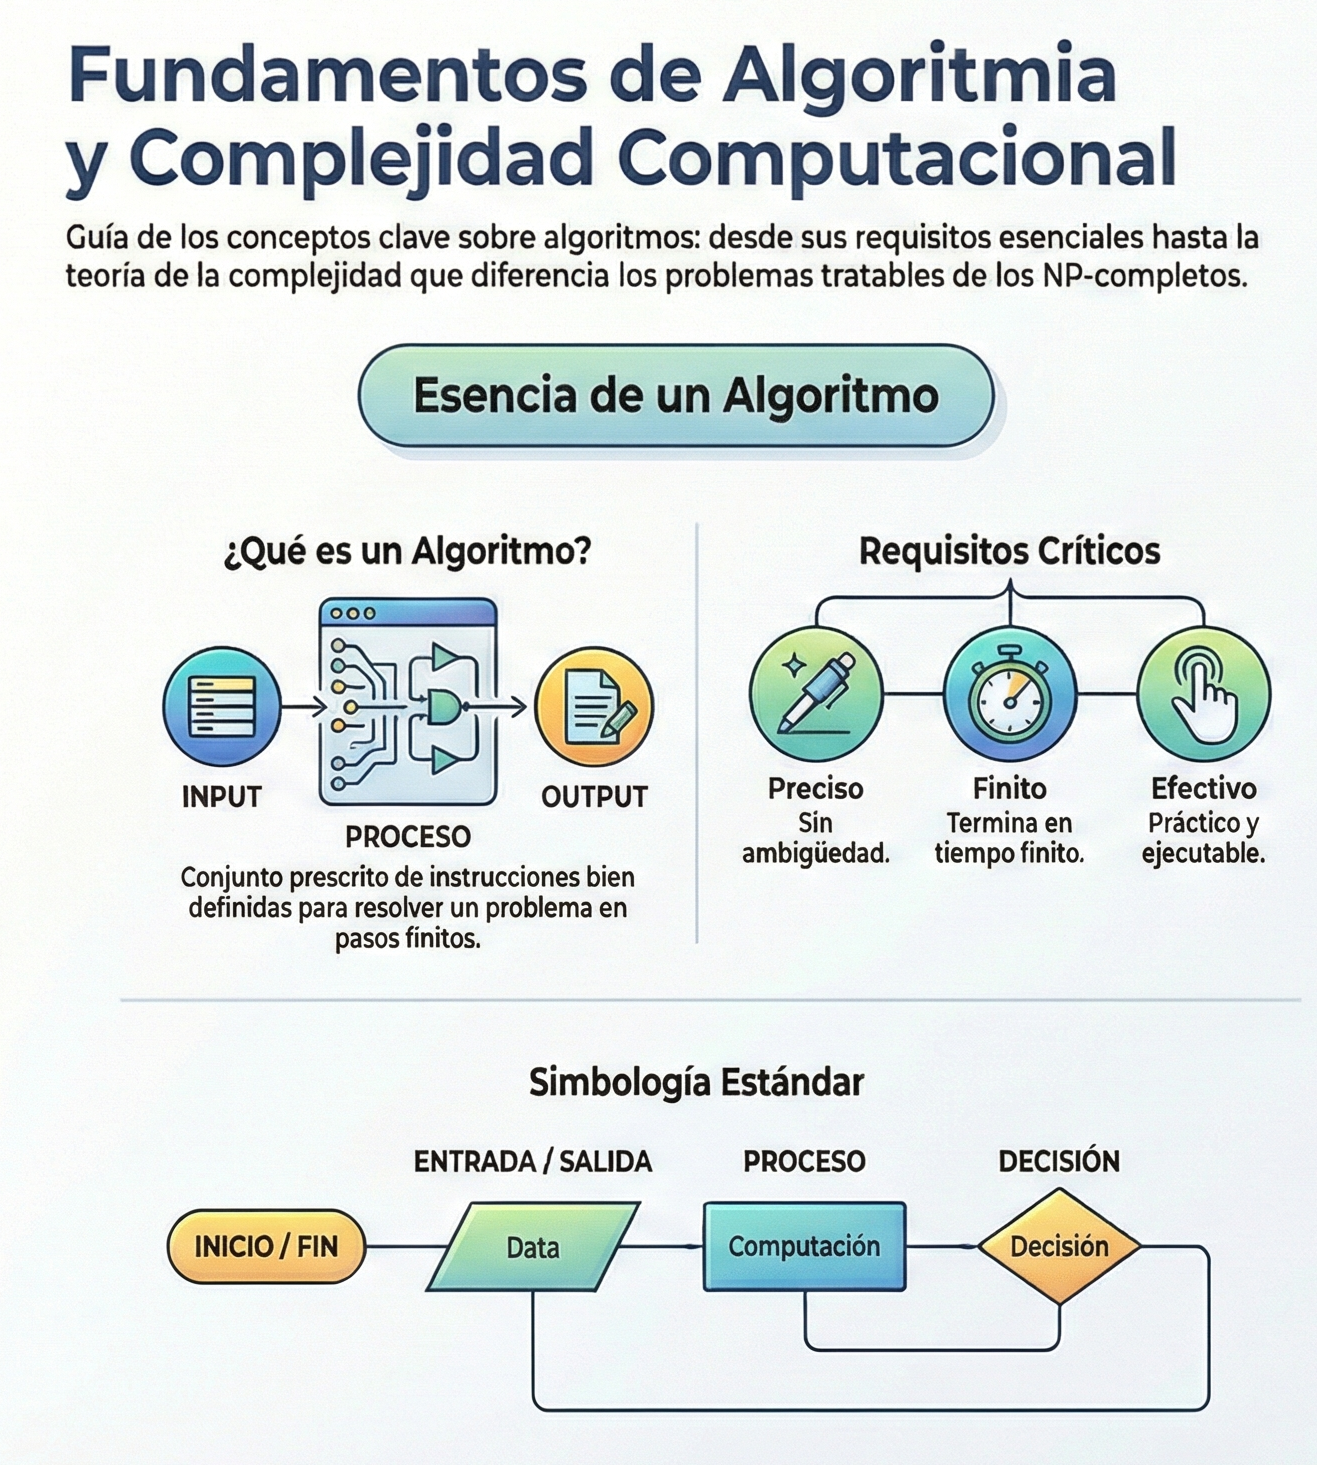
El concepto de algoritmo ha evolucionado desde una acepción antigua, centrada en reglas para operaciones algebraicas, hacia una visión moderna: un conjunto prescrito de reglas o instrucciones bien definidas para resolver un problema específico en un número finito de pasos. En esencia, se trata de un método para manipular información mediante operaciones elementales.

A continuación, desvelamos cinco realidades esenciales para navegar por este universo de precisión y complejidad.

1. Los pilares del rigor: más allá del simple «paso a paso».

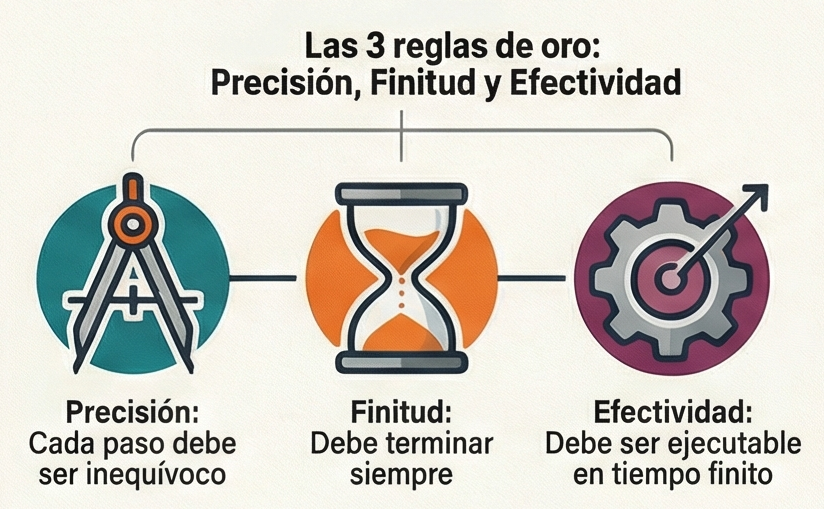
A menudo se define el algoritmo como una lista de instrucciones, pero para la ciencia de la computación esta definición es insuficiente. Un algoritmo debe ser un baluarte contra la ambigüedad, ese «fantasma en la máquina» que detiene en seco cualquier proceso lógico. Un método solo alcanza la categoría de algoritmo si cumple cuatro condiciones necesarias, pero no suficientes.

  • Precisión: cada instrucción debe indicar exactamente qué acción realizar, sin margen de interpretación.
  • Finitud: el proceso debe tener un final garantizado tras un número determinado de pasos.
  • Efectividad: cada operación debe poder ser ejecutada por el ejecutor (humano o máquina) en un tiempo finito.
  • Entrada y salida: debe existir un punto de partida de datos y un resultado concreto.

La finitud no es solo una exigencia teórica, sino también una restricción física. En un mundo de recursos limitados, un proceso que no termina nunca no es una solución, sino un abismo de consumo de energía.

2. El enigma de P vs. NP

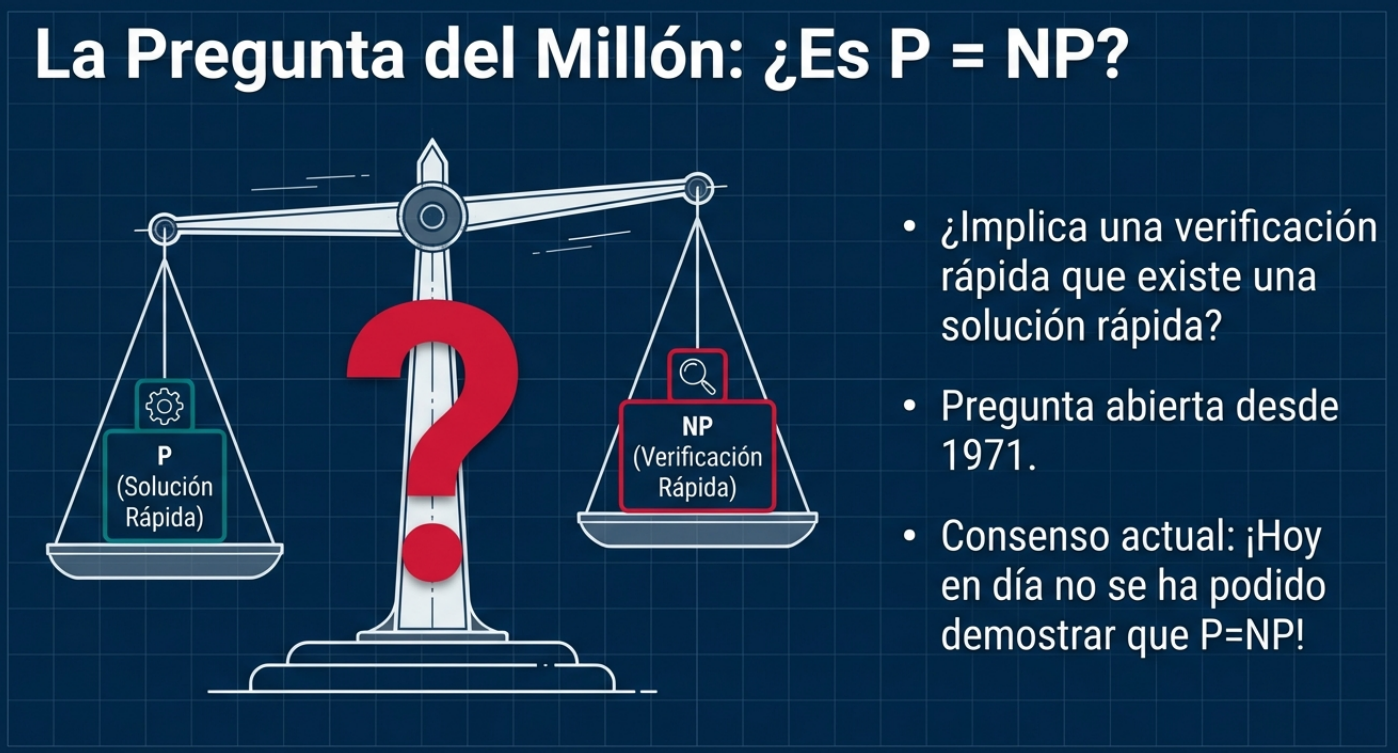
Existe una frontera que divide los problemas en dos grandes categorías. Por un lado, la clase P, que agrupa los problemas que podemos resolver rápidamente (de forma eficiente). Por otro lado, está la clase NP, que incluye problemas cuya solución, aunque difícil de encontrar, puede verificarse con rapidez una vez que la tenemos. La gran pregunta que obsesiona a los genios desde 1971 es si resolver es intrínsecamente más difícil que verificar.

«¡Hoy en día no se ha podido demostrar que P = NP!»

Científicamente, sabemos que P ⊂ NP, pero el gran misterio radica en el «empate». Si se demostrara que P = NP, significaría que para la mayoría de los retos complejos de nuestra era —desde la criptografía hasta el diseño estructural— existen algoritmos de una eficiencia asombrosa que aún no hemos logrado ver.

3. La tiranía del tiempo: el análisis del «peor caso».

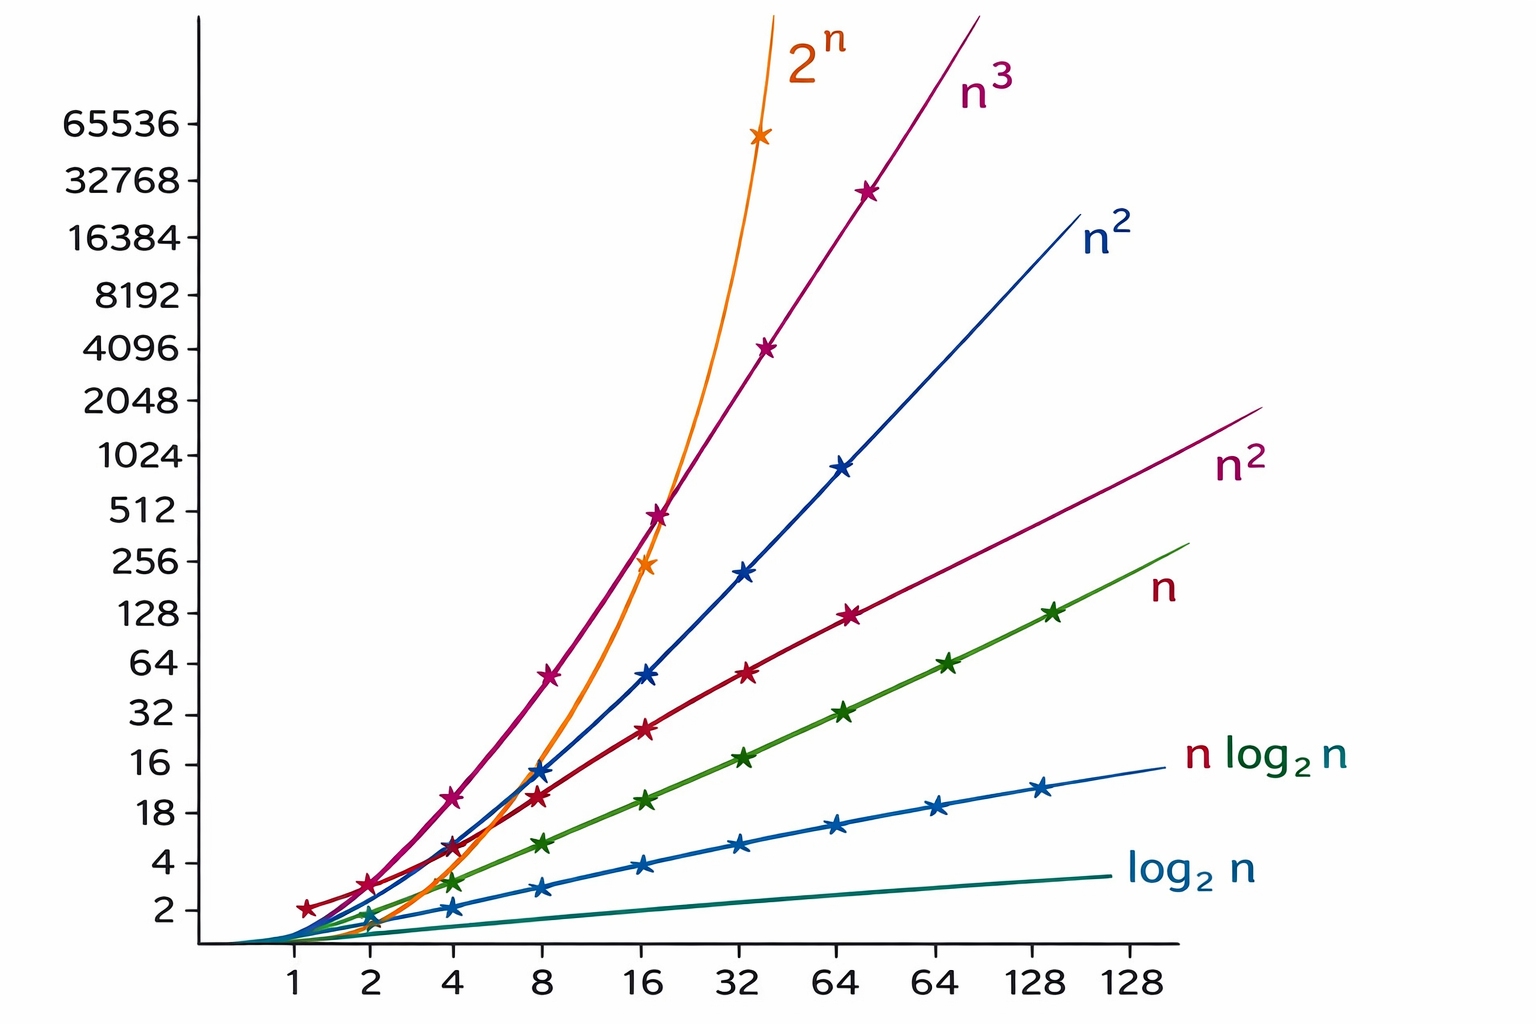
En ingeniería y computación, el rendimiento no es cuestión de suerte. Para medirlo, recurrimos a la teoría del análisis asintótico de funciones, que nos permite predecir cómo crecerá el esfuerzo de cálculo a medida que aumenta la dimensión del problema (n). Para un especialista, no basta con saber cuánto tarda un algoritmo de media; lo vital es el análisis del peor caso. Este define el coste máximo de aplicar el algoritmo a cualquier problema de tamaño n.

Aquí es donde la matemática se vuelve tangible. Imagine que n representa el número de ciudades que un camión debe visitar.

  • Complejidad polinómica (O(n^k)): El tiempo crece de forma controlada. Estos problemas se consideran «resolubles eficientemente».
  • Complejidad exponencial: El tiempo de cálculo aumenta de forma exponencial. Un ligero aumento en el número de ciudades puede hacer que el ordenador necesite más tiempo que la edad del universo para hallar la respuesta.
Orden de magnitud de un algoritmo

4. El drama de los problemas NP-completos.

Dentro del vasto territorio de la clase NP, existe una «aristocracia» del caos: los problemas NP-completos (NPC). El ejemplo más célebre es el problema del viajante (O(n² 2^n)). Estos problemas son fascinantes porque están interconectados: si alguien lograra encontrar un algoritmo polinómico para resolver un problema NPC, automáticamente todos los problemas NP pasarían a ser resolubles de manera eficiente.

Mientras ese día no llegue, los problemas NPC representan el muro contra el que choca la potencia bruta. En ellos, añadir un solo dato más a la entrada no solo implica trabajo, sino que multiplica la dificultad hasta el punto de que la realidad física se vuelve incapaz de soportar el cálculo.

5. El arte de la heurística: la sabiduría de lo «suficientemente bueno».

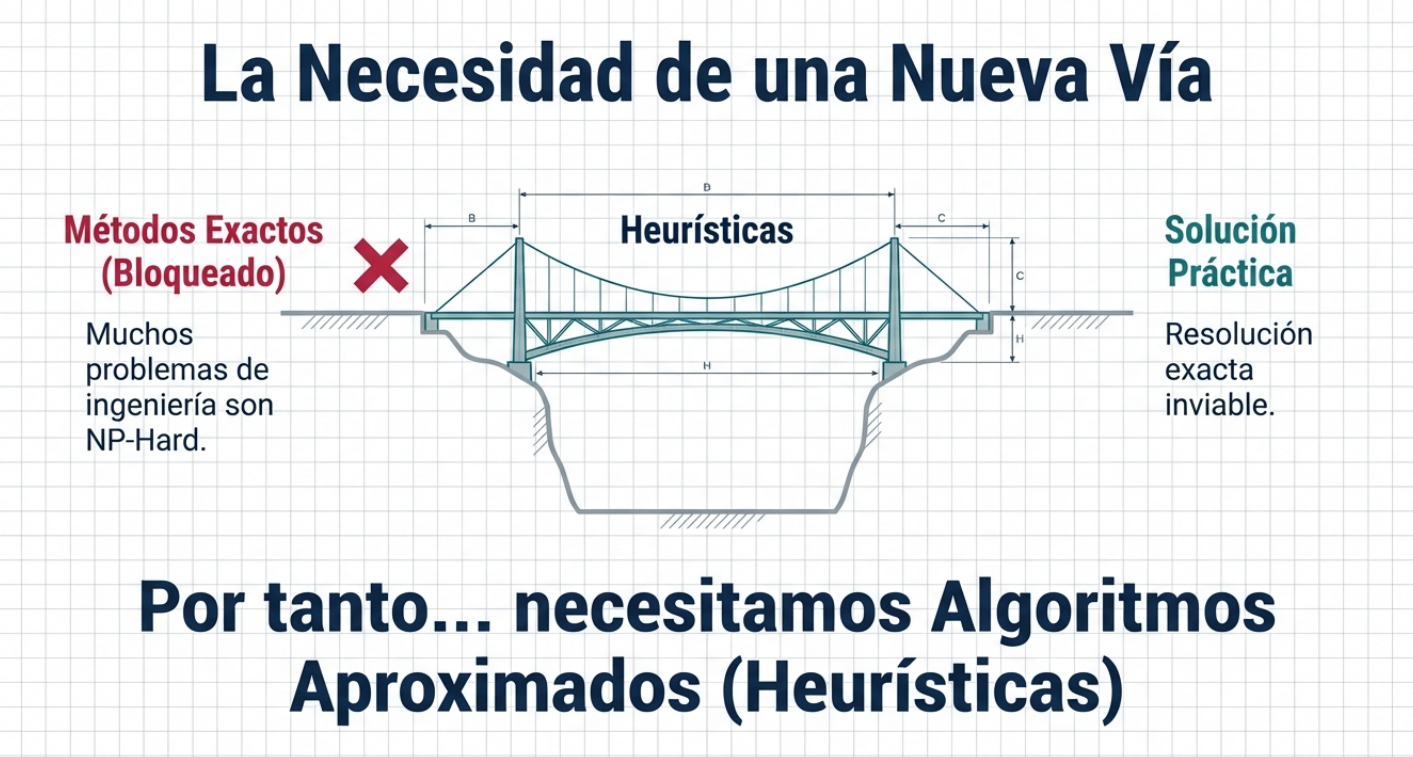
¿Qué debe hacer un ingeniero ante un problema cuya solución perfecta tardaría milenios en aparecer? La respuesta está en las heurísticas y las metaheurísticas. Se trata de algoritmos aproximados que actúan como un «Plan B» inteligente cuando la perfección se convierte en el enemigo de lo posible.

Sin embargo, el orden de los factores sí altera el producto. Si un problema de optimización se presenta en forma algebraica, es imperativo intentar primero las técnicas clásicas. No tiene sentido utilizar una heurística si los métodos Simplex (para problemas lineales) o de gradiente (para problemas no lineales) pueden proporcionarnos la respuesta exacta. Solo cuando estas herramientas fallan o su lentitud resulta inasumible, recurrimos a la intuición algorítmica.

Conclusión: Hacia una nueva frontera de optimización.

El viaje desde las antiguas reglas de cálculo hasta la optimización de las estructuras de hormigón modernas nos enseña que el límite de la ingeniería no está en la potencia de los procesadores, sino en la elegancia de nuestros métodos. El éxito consiste en saber navegar entre el rigor asintótico y la flexibilidad heurística.

En última instancia, nos enfrentamos a una pregunta que definirá el futuro de nuestra capacidad técnica: ¿residirá el progreso en la búsqueda incansable del algoritmo perfecto que demuestre que P = NP o en perfeccionar nuestra capacidad para utilizar la intuición heurística y construir un mundo «suficientemente bueno» antes de que se agote el tiempo?

En esta conversación podéis escuchar las ideas más interesantes sobre este tema.

El vídeo resume bien los conceptos más importantes de la algoritmia y la complejidad computacional.

Aquí os dejo un resumen de este asunto.

Algorithmic_Complexity_and_Structural_Optimization

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.
Un algoritmo que imita al metal para resolver problemas imposibles

Introducción: Atrapado en lo «suficientemente bueno».

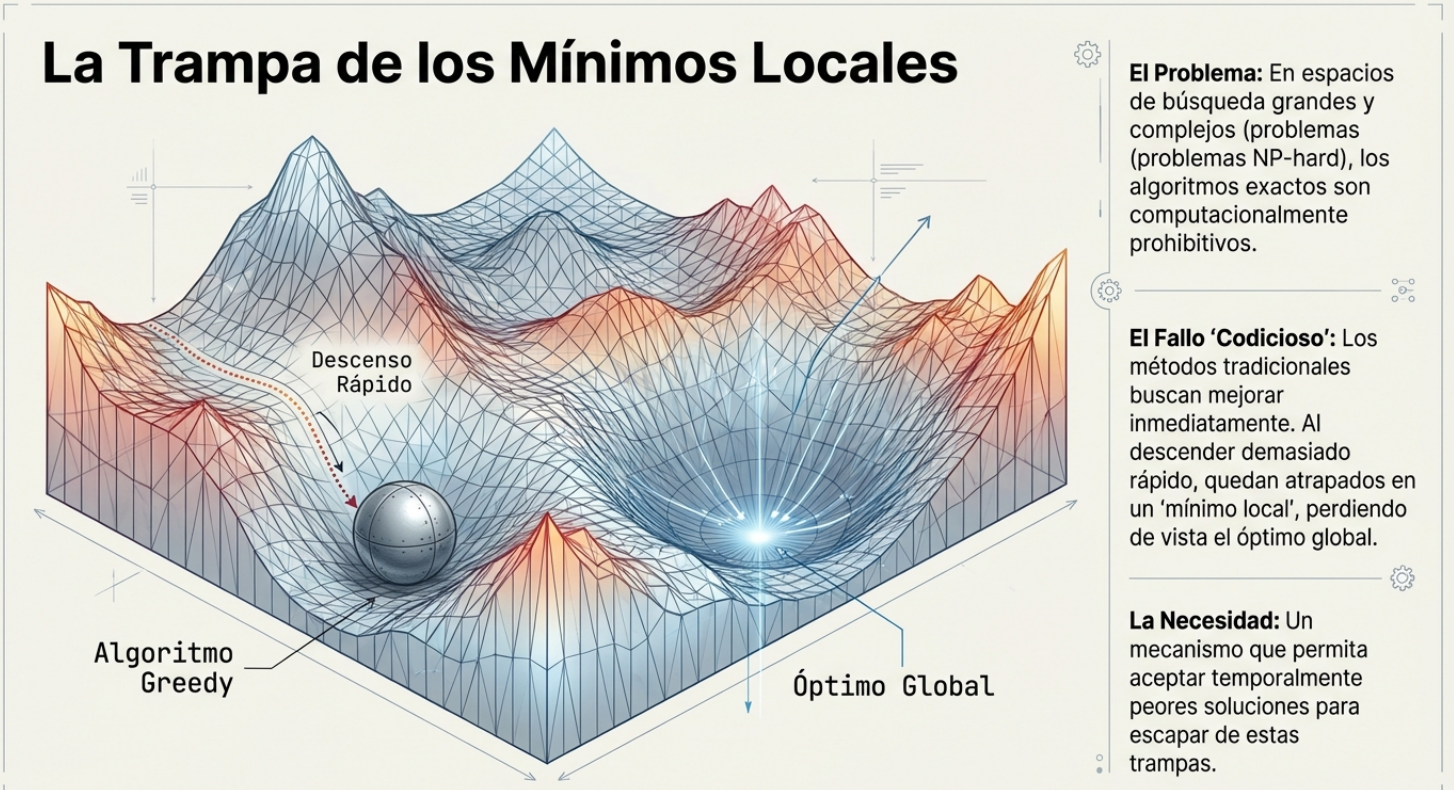
¿Alguna vez has sentido que encontraste una solución funcional a un problema, pero tenías la persistente sensación de que existía una respuesta mucho mejor? En la vida y en la tecnología, es fácil quedarse atascado en una solución «buena», pero no óptima, en un callejón sin salida conocido como «mínimo local». Salir de ahí requiere una estrategia poco convencional.
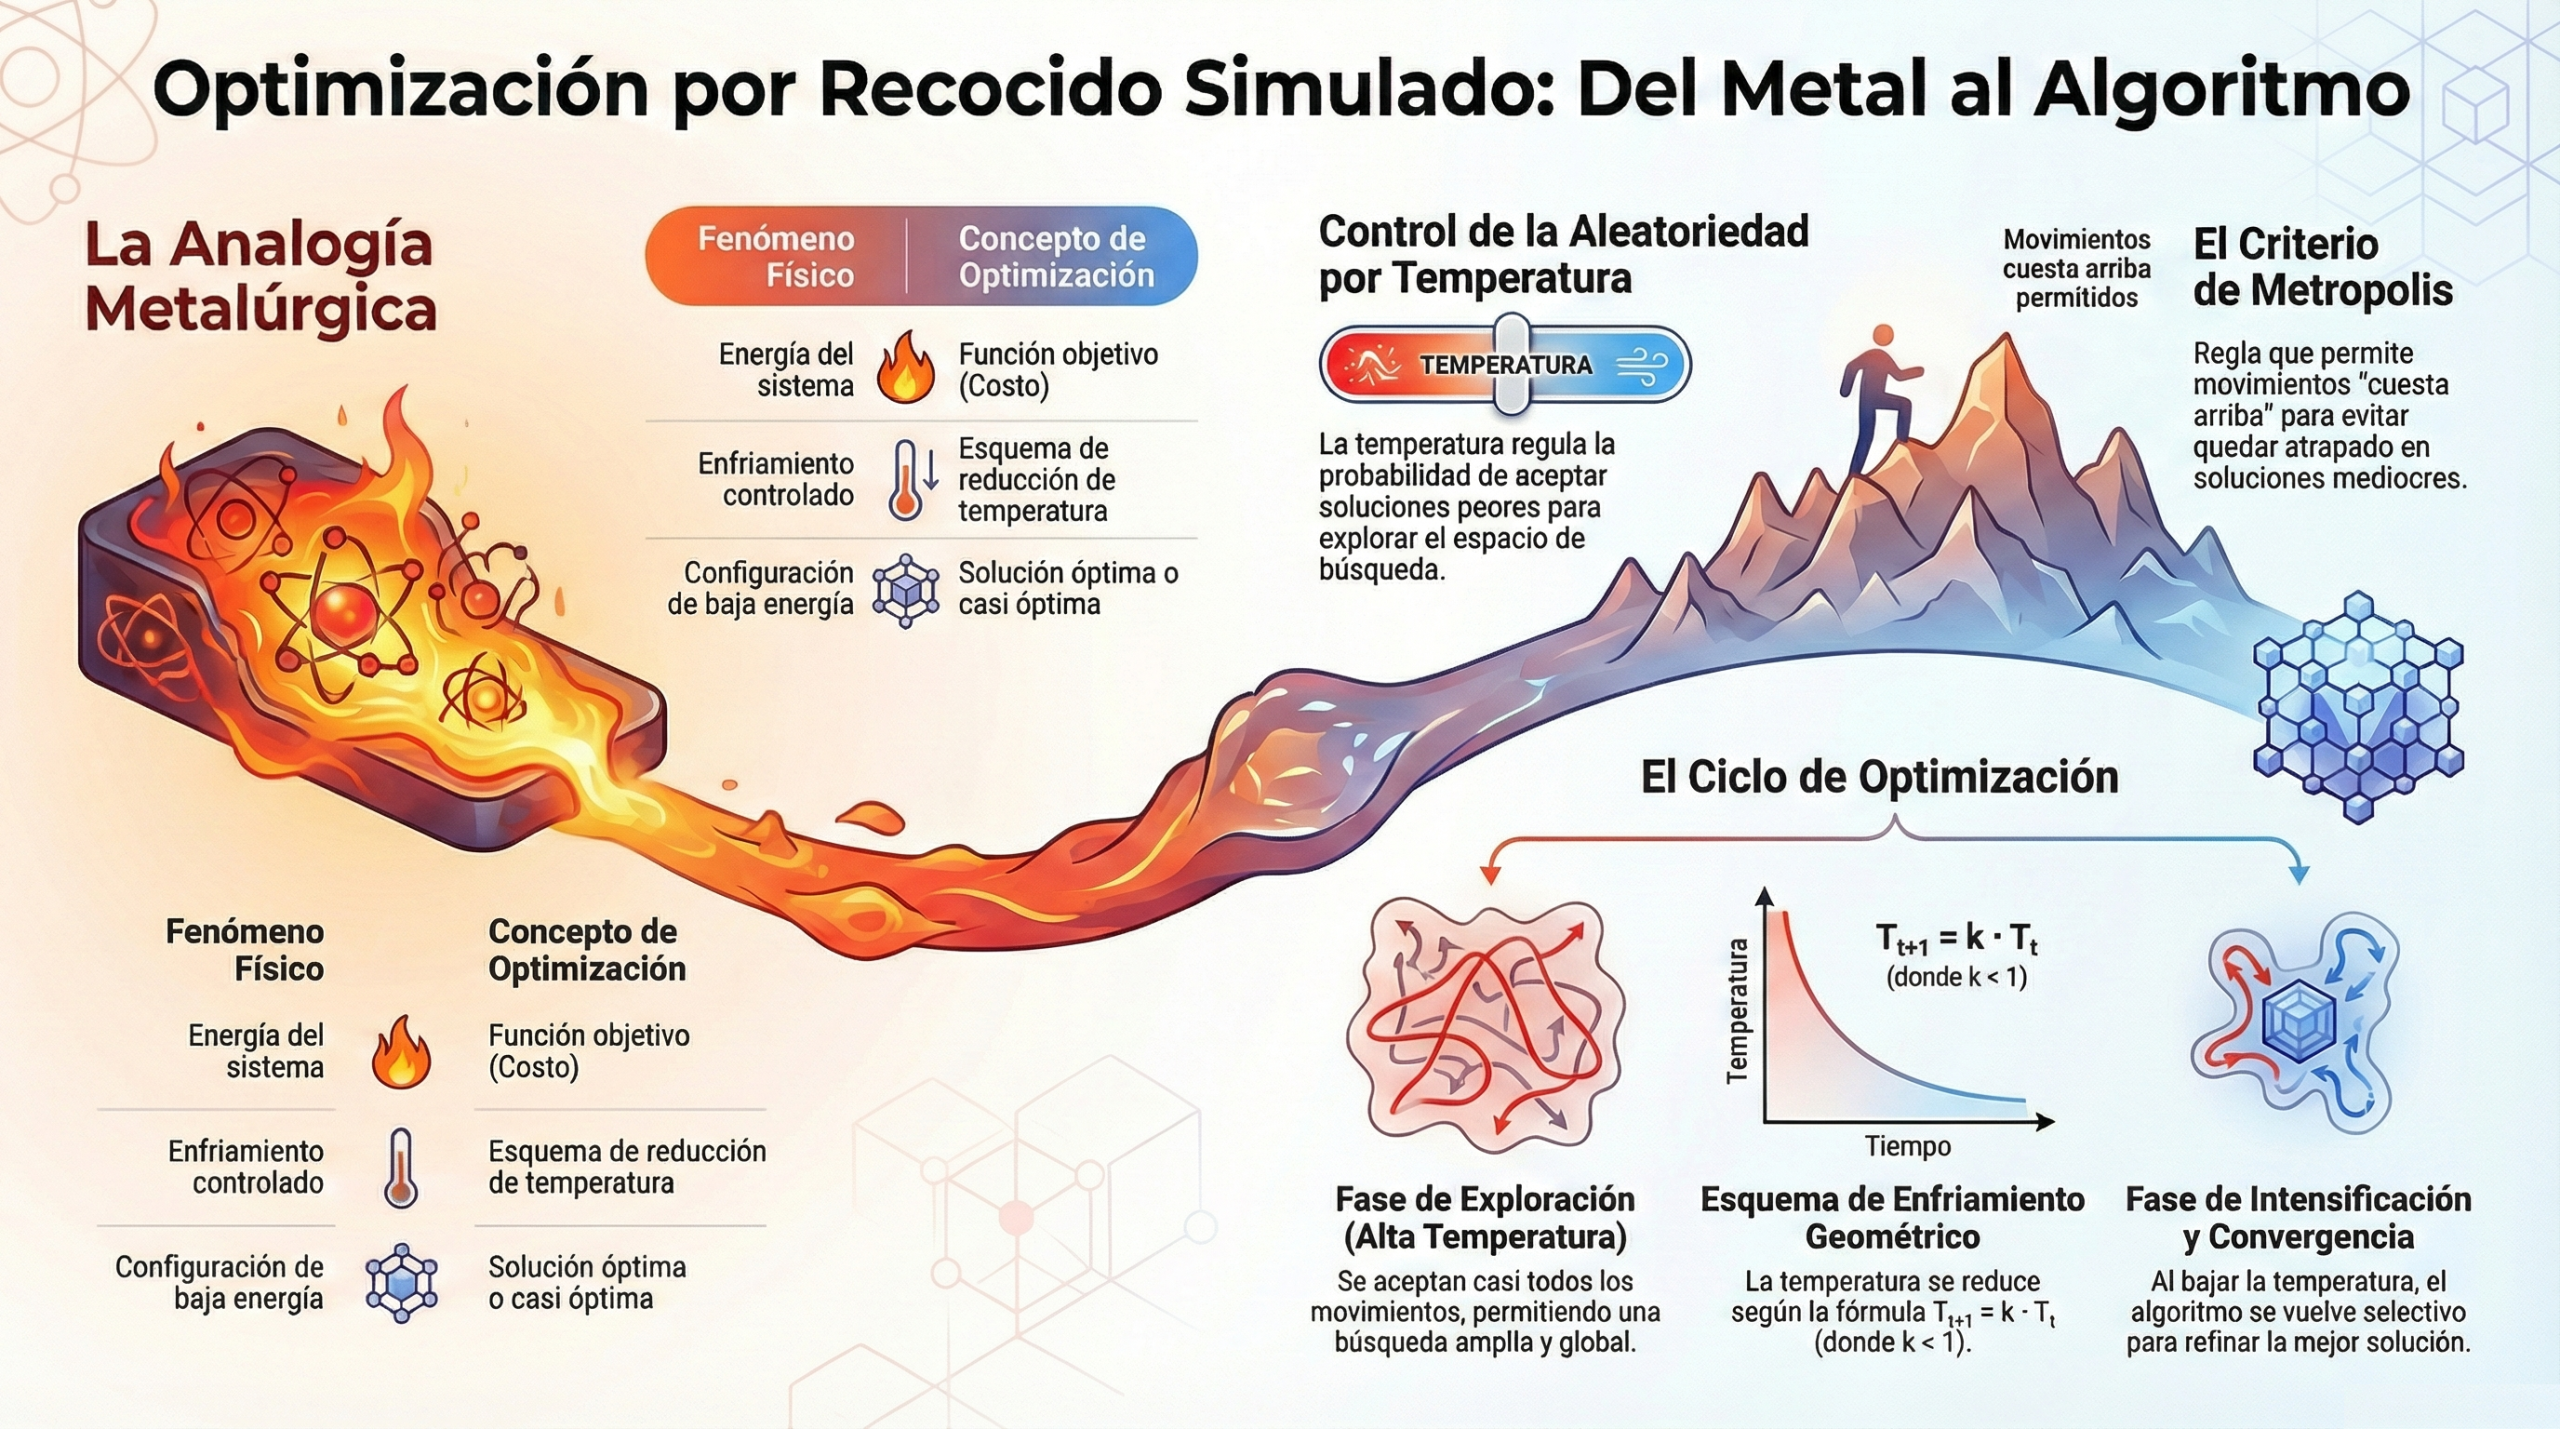
Es aquí donde entra en juego el recocido simulado, una ingeniosa metaheurística estocástica que toma su inspiración de la metalurgia. Desarrollado de forma independiente por Kirkpatrick, Gelatt y Vecchi en 1983 y por Černý en 1985, este algoritmo es, en esencia, una estrategia de búsqueda inteligente que utiliza la aleatoriedad de forma controlada para encontrar soluciones óptimas en problemas de gran complejidad.

Este artículo explora las lecciones más sorprendentes y contraintuitivas que este poderoso algoritmo puede enseñarnos para abordar y resolver problemas verdaderamente complejos.

1. El secreto está en la metalurgia: un algoritmo que piensa como un herrero.

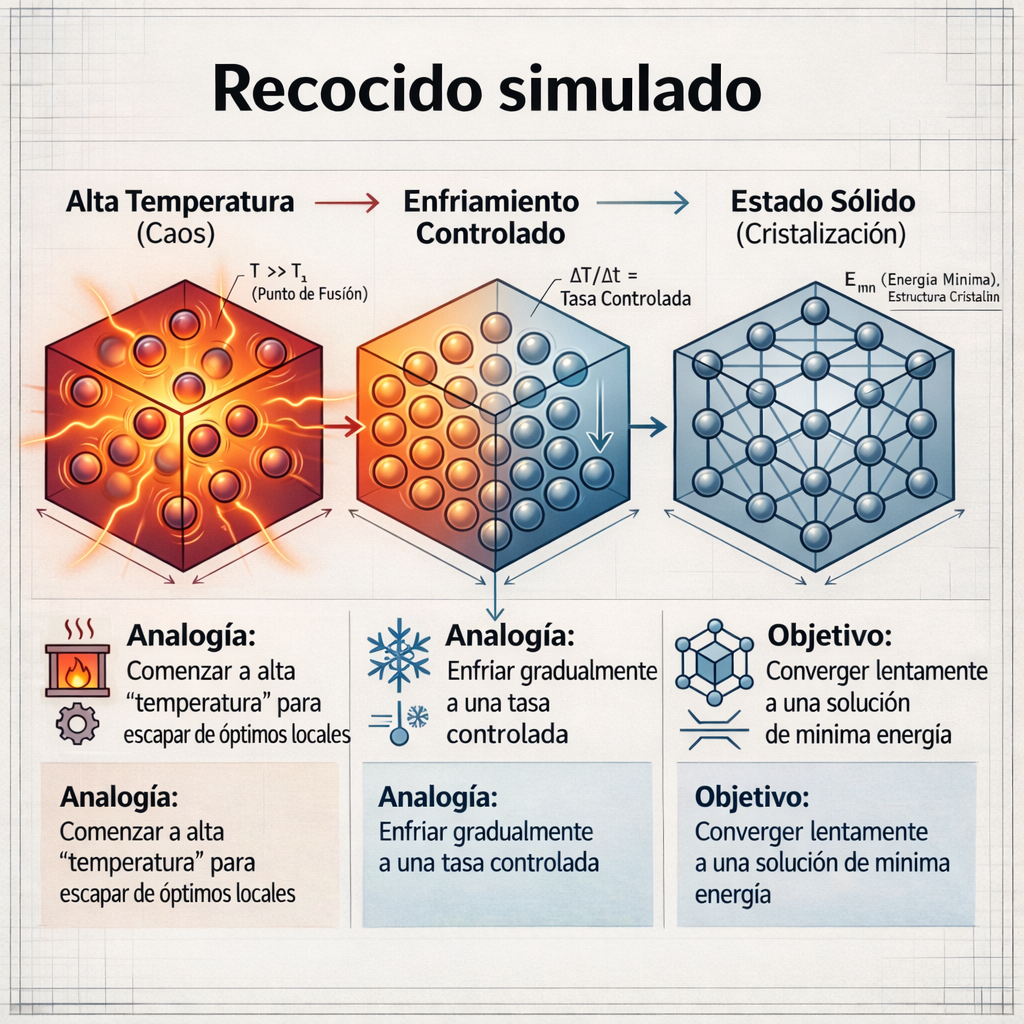
La genialidad del recocido simulado radica en su analogía directa con el proceso de recocido de metales. El herrero calienta el metal a altas temperaturas y luego lo enfría lentamente y de forma controlada para eliminar sus imperfecciones y lograr una estructura interna sólida y estable. El algoritmo hace exactamente lo mismo, pero en el mundo abstracto de los datos y las soluciones.

Los conceptos clave de esta analogía son:

  • «Temperatura» alta: al principio, el algoritmo opera a una «temperatura» elevada. Esto corresponde a una fase de exploración amplia, en la que se consideran muchísimas soluciones posibles, incluso las que parecen malas, para obtener una visión global del problema.
  • «Enfriamiento» controlado: a medida que avanza el proceso, la «temperatura» se reduce gradualmente. Este «enfriamiento» suele seguir un programa geométrico (como Tt + 1 = α·Tt), lo que obliga al algoritmo a ser más selectivo. Se pasa de la exploración a la explotación, enfocándose progresivamente en las regiones más prometedoras.
  • «Energía» del sistema: en el algoritmo, la «energía» de una configuración corresponde a la función objetivo que se busca optimizar (por ejemplo, minimizar el coste, la distancia o el error).
  • «Estructura cristalina estable» de baja energía: el objetivo final del recocido es lograr un estado de mínima energía que, en el ámbito de la optimización, representa la solución óptima o casi óptima del problema.

2. La estrategia contraintuitiva: aceptar un empeoramiento para poder mejorar.

La característica más paradójica y, a la vez, más poderosa del recocido simulado es su capacidad para aceptar movimientos que, en un principio, empeoran la solución actual. Esa es la esencia de la exploración: a diferencia de los algoritmos «codiciosos» que solo aceptan mejoras, este método sabe que, a veces, hay que atravesar un pequeño valle para escalar una montaña más alta.

No se trata de un error, sino de una estrategia deliberada para evitar quedar atrapado en los mínimos locales. Antes de reducir la temperatura, el algoritmo ejecuta una serie de iteraciones (una cadena de Markov) para explorar a fondo el entorno de la solución actual. La probabilidad de aceptar un «mal» movimiento es mayor cuando la «temperatura» es alta y disminuye a medida que el sistema se «enfría», según el factor de Boltzmann exp(-ΔE/T). Al principio, la exploración es agresiva, pero al final el algoritmo se vuelve mucho más selectivo.
«Esta aceptación controlada de transiciones no mejoradoras permite al algoritmo escapar de los mínimos locales y evitar una convergencia prematura».

3. La perfección es enemiga de lo práctico: por qué «casi óptimo» es un gran resultado.

Teóricamente, para garantizar que el recocido simulado encuentre la solución globalmente óptima, podría requerir un tiempo de ejecución infinito. Sin embargo, su verdadero valor no radica en la perfección teórica, sino en su gran pragmatismo. La lección fundamental aquí es el equilibrio entre la perfección teórica y la aplicación práctica.

El algoritmo «produce de forma consistente soluciones de alta calidad en escalas de tiempo computacionales prácticas». En ingeniería, logística o finanzas, donde los recursos y el tiempo son limitados, una solución excelente entregada a tiempo es mucho más valiosa que una solución perfecta que nunca se entrega. El recocido simulado encarna este principio de diseño esencial: optimizar para el mundo real, no para un ideal teórico.

4. De vendedores viajeros a puentes de hormigón: la asombrosa versatilidad del algoritmo.

La solidez del recocido simulado se evidencia en la increíble diversidad de problemas que puede resolver. Su capacidad para explorar paisajes de soluciones complejos lo convierte en una herramienta fiable cuando no existen solucionadores específicos para un problema.

Algunos de sus campos de aplicación más impactantes incluyen:

  • Rutas y logística: Ha demostrado su eficacia al resolver el problema del vendedor viajero (TSP), encontrando rutas óptimas para conectar múltiples ciudades.
  • Procesamiento de imágenes: Se utiliza en la restauración de imágenes dañadas o con ruido, así como para resolver problemas de segmentación complejos.
  • Química molecular: Es una herramienta estándar en la cristalografía de macromoléculas que permite determinar la estructura tridimensional de moléculas complejas.
  • Ingeniería estructural: Permite realizar optimizaciones de gran impacto, como el diseño de puentes de hormigón pretensado, muros de contención de bajo coste y, en especial, la minimización simultánea del coste y de las emisiones de CO₂ en el diseño de columnas de hormigón armado.

5. A veces, una regla simple supera al azar: la alternativa determinista.

Un giro interesante en la historia de este algoritmo es la variante llamada «Aceptación por umbral» (TA, por sus siglas en inglés). Este método sustituye la regla de aceptación probabilística del recocido simulado por una regla determinista mucho más sencilla.

En lugar de calcular una probabilidad, TA solo acepta una solución peor si el empeoramiento es inferior a un umbral predefinido. Este umbral, al igual que la temperatura del algoritmo original, disminuye gradualmente a lo largo del proceso. Lo sorprendente es el resultado: estudios empíricos han demostrado que, en ciertos problemas como la planificación de tareas, la planificación forestal y la asignación de recursos, este método más simple «puede tener un rendimiento comparable o incluso superior al SA». Una lección de que, a veces, la solución más elegante no es la más compleja.

Conclusión: ¿te atreves a dar un paso atrás?

La gran lección del recocido simulado es una profunda metáfora de la resolución de problemas: el progreso no siempre es una línea recta. La verdadera optimización requiere dominar el cambio gradual, desde una exploración audaz hasta una explotación enfocada. Aceptar retrocesos temporales y controlados no es un signo de fracaso, sino una estrategia inteligente para alcanzar un objetivo mucho más alto a largo plazo.

La próxima vez que te enfrentes a un problema complejo, ¿te atreverás a explorar un camino que parezca peor al principio para encontrar una solución verdaderamente excepcional al final?

En esta conversación puedes escuchar las ideas más interesantes sobre el tema.

Este vídeo resume bien los conceptos más importantes del Simulated Annealing.

Te dejo un documento que puede interesarte.

Recocido_Simulado_Del_Caos_a_la_Solución

Referencia:

Yepes, V. (2026). Heuristic Optimization Using Simulated Annealing. In: Kulkarni, A.J., Mezura-Montes, E., Bonakdari, H. (eds) Encyclopedia of Engineering Optimization and Heuristics. Springer, Singapore. https://doi.org/10.1007/978-981-96-8165-5_48-1

Licencia de Creative Commons
Esta obra está bajo una licencia de Creative Commons Reconocimiento-NoComercial-SinObraDerivada 4.0 Internacional.